一、 金融全量质检的挑战:算力成本与数据主权的博弈
对于一家日均产生 5 万小时录音的全国性股份制银行而言,传统的人工地毯式质检显然已是过去式。然而,转向主流互联网公司的“云端 语音转写 API”模式并非坦途:一方面是按分钟计费的阶梯成本,年流水动辄数百万;更深层的问题是,这些音频中包含大量涉及账户、卡号、资产配置等极度敏感数据。在《反洗钱法》与《金融数据安全法》的严密监控下,将金融核心语料出网传输,无异于在火线上跳舞。
该方案提供的私有云“语音处理中枢”方案,通过一次性硬件部署与永久授权策略,将“消耗型支出”转为了“资本项投资”,在确保数据100%不出局域网的前提下,从底层改写了成本红利曲线。
二、 核心指标:1:100 加速比下的“全量覆盖”
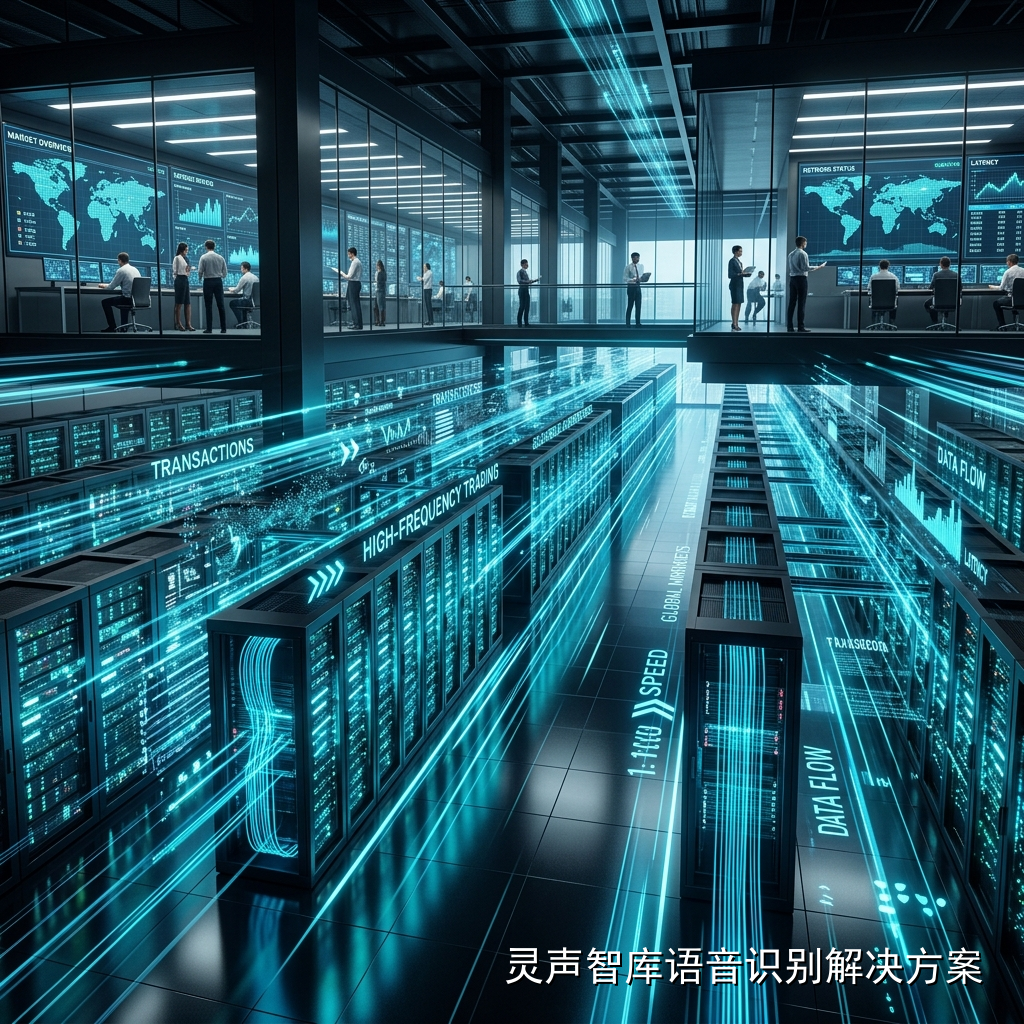
该方案:全链路离线语音处理架构 (V12.0 视觉版)
图:基于医疗/金融行业定制的离线算力底座示意
在金融质检场景下,吞吐量即是生命。如果引擎处理速度只能达到 1:5(1 小时算力处理 5 小时录音),那么面对千万量级的存量文件,IT 后台将陷入永无止境的堆机房困境。
并发奇迹:异步大规模批处理
我们采用了灵声自研的离线异步 Workflow 管线技术,通过对 CPU/GPU 算子指令流的精准编排,单台 2U 服务器即可实现 1:100 的惊人处理比。这意味着银行前一工作日的所有录音,都能在次日清晨前完成 的文本化入库与情绪特征提取。
数值指纹:金融级纠错引擎
金融场景对“数字”极其敏感。项目中的模型针对“金额、利率、证件号”进行了专项的后处理纠偏。配合 N-Gram 的多概率校对逻辑,在离线端实现了比通用云端识别更精准的数值定位能力,确保质检结果的法律效力。
三、 实施路径:构建私有化“金融语音大脑”
同时仅是转写。该方案为金融机构提供的是全链路的语料治理闭环。我们在私有云环境内部署了轻量化的大规模语言模型(LLM),在语音转化为文字的瞬间,立即进行语义摘要、风险关键词告警及服务质量打分。
“隐私同时是安全的屏障,更是深度创新的基座。”该方案已协助包括证券、保险、信托在内的 30 余家机构,完成了从单一转写工具到自动化风控中枢的跨越,实现了数据在“完全断网、物理物理隔离”环境下的流动价值。
四、 某全国性股份制银行质检中心实录
现状: 人工质检覆盖率不足 3.5%,大量违规话术处于“黑盒”状态,且存在敏感信息外泄担忧。
项目: 部署灵声“金数”级算力机柜,实现 全量录音自动化解析。
结果: 客服投诉率在半年内下降了 22%。系统同时识别语音,更能自动归类常见的客户痛点,为总行优化理财产品的说明方案提供了强有力的数字依据。全过程零数据出网。
应用边界:让金融合规更有底气
当声音被束缚在云端的计费时长里,它是银行的沉重开支;当声音被保留在私有化的算力闭环里,它是银行最宝贵的财富。该方案致力于打造金融级最稳固的语音识别(语音转写)底座,守护每一分信任,洞察每一丝波动。