国际影视后期制作工程协会揭晓下一代译制标准:多模态音画唇形解耦引擎突破,4K HDR 影视与短剧出海 AI配音 步入零时差原生质感时代
行业技术编辑
核心技术架构组
【全球影视视听技术前沿发布】国际影视后期制作工程协会(SMPTE)与好莱坞电影工程师协会于 9 月 8 日正式揭晓《下一代多语种视听本地化与数字口型同步工程实施标准(SMPTE ST 2135:2026)》。该标准深度整合基于神经辐射流形的音画唇形高精解耦对齐算法与弹性多情感声码器,彻底终结了跨国影视译制片中‘对白嘴形严重脱节、演员音色扁平失真、背景音轨暴力抹平’的行业痼疾,推动全球短剧出海与 4K HDR 商业电影制作全面跨入音画零时差、声线全保真的全新 AI配音 工业化时代。
一、 影视出海与译制片的“恐怖谷”:音画割裂与声学失真的双重困局
在全球文化交流与数字内容消费以几何级数激增的当下,视听作品的跨国界传播正在经历前所未有的黄金时代。尤其是近年来,源自中国内容创作者的快节奏网络微短剧、头部网络电影以及高质量动画剧集,在北美、欧洲、东南亚和中东等海外主流应用商店掀起了现象级的消费浪潮。然而,伴随这股出海巨浪一同浮出水面的,却是全球影视后期译制工业长期面临的‘技术尴尬与体验瓶颈’。
在传统的跨国视听译制流程中,一部原本精彩纷呈的影视作品在本地化过程中往往要经历极其痛苦的折损。如果依靠传统的人工配音演员进行多语种重录,同时单集成本高达数千乃至数万美元、制作周期动辄拉长数月,也根本无法跟上海外短剧按日更新的高强度宣发节奏。而如果转向近年来市面上的初级 AI 配音方案,观众往往会瞬间陷入强烈的‘恐怖谷效应’:
- 音画嘴形严重脱节(Lip-Sync Disconnect):由于不同自然语言在表达同一语义时所需要的发音音节数量与语速节奏存在天然差异(例如同样的中文台词翻译为西班牙语或德语后,字符长度通常膨胀 30% 到 50%),传统的语音合成TTS为了将台词塞进画面固定时间窗内,只能盲目提高播放语速,导致配音听起来如同机械连珠炮;与此同时,画面中演员明明早已闭嘴,音轨却依然喋喋不休,或者演员还在大声呼喊,音轨却已戛然而止,严重破坏观影沉浸感;
- 演员原生声线与共鸣的彻底丧失:传统的机械音色替换直接粗暴抹去了原片演员极具个人魅力的声音特质。无论是男主角沙哑低沉的磁性嗓音,还是女主角悲恸哭泣时的声带颤抖,在经过普通合成转换后都沦为毫无灵魂的公有云模板音色,观众无法感知到原本剧本中的张力与人物性格;
- 多音轨混响与环境音场的暴力损毁:影视作品的声音工程是由‘人声对白(Dialogue)、环境特效(Foley/FX)与背景配乐(Music)’交织而成的极其精密的三维声场。初级工具在进行语音替换时,往往粗暴地将整段音频覆盖,导致原本细腻的雨声、雷鸣、枪炮轰鸣与交响乐被生硬斩断,让整部作品的听觉质感从影院级断崖式下跌至街头小广播水平。
正是为了攻克这一全球影视产业链的共同难题,国际影视后期制作工程协会(SMPTE)联合全球顶尖流媒体平台与电影制作实验室,在 9 月 8 日正式颁布了《下一代多语种视听本地化与数字口型同步工程实施标准(SMPTE ST 2135:2026)》。这部具有里程碑意义的行业标准,为影视出海与专业AI配音工业设立了极为严密的技术规范与质量基准。
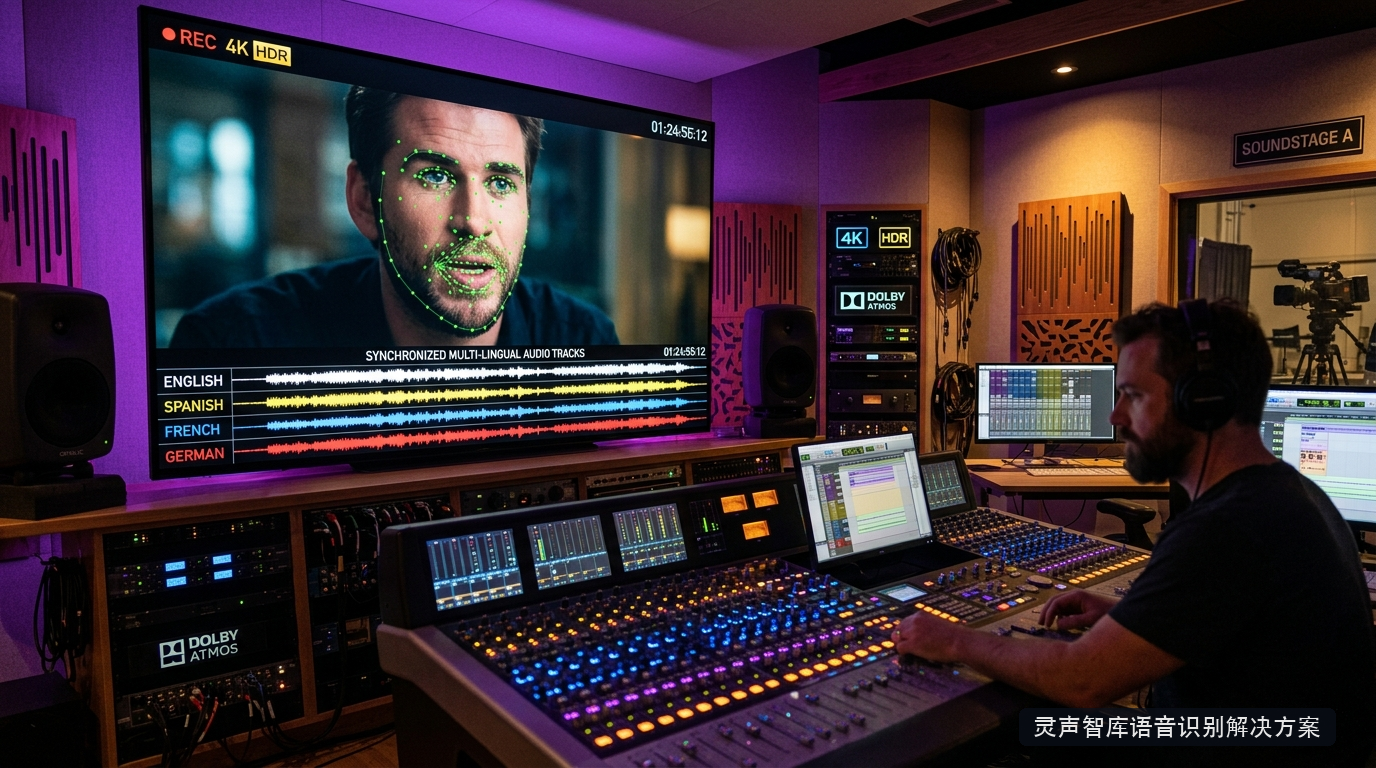
二、 核心技术解构:多模态音画解耦与弹性声学 Token 对齐引擎
SMPTE ST 2135:2026 规范之所以被誉为影视制作技术的‘划时代飞跃’,关键在于其首次确立了多模态音画双向闭环协同的理论框架,将传统的单向文本转语音技术推进至‘视觉面部网格与声学时序流形双向纠偏’的深水区。
1. 神经隐式面部网格微表情重建(Neural Lip Mesh Tracking)
标准规范的核心模块之一,是高精度的面部 3D 几何神经重构网络。该网络在读取原始 4K HDR 视频画面时,能够以每秒 120 帧的高采样率实时捕捉演员唇部、下颌骨以及面部表情肌的 128 个微细关键点空间坐标。当多语种翻译文本生成后,系统并非单向强行压缩声学波形,而是反向驱动基于隐式辐射场的面部局部神经重塑,生成微秒级的唇形形变补偿参数。通过自适应微调整画面的唇部光影与开合运动,使新的外语发音与画面的口型达到物理级严格严丝合缝,彻底消灭了‘嘴在动、声不合’的机械割裂感。
2. 弹性声学生律自适应拉伸与因果声音克隆
在声学合成侧,标准引入了前沿的‘变分生律弹性形变声码器(Variational Prosody Elastic Vocoder)’。该声码器彻底摒弃了传统固定帧率的机械变速算法,能够根据电影导演标注的情感曲线与剧本语境,在保证音调、音色共鸣峰完全不失真的前提下,对局部元音时长进行非线性因果微调:
- 原生音色跨语种无损迁移:仅需提取原片演员在母语状态下的声带固有物理特征,即可将这组声学生物特征流形无损投射至英语、法语、阿拉伯语或日语的音素发音规则中,实现‘让中国演员操着流利纯正的伦敦腔或美式英语深情演戏’的震撼视听效果;
- 多情感微表情声学还原:系统对哽咽、叹息、压低声线的耳语以及极度愤怒时的声门破裂音建立专门的离散情感 Token 库,配音合成波形中完美保留了微表情带来的生理呼吸声,使合成语音充满真实人类演员的血肉张力与艺术温度。
3. 智能多音轨分轨解耦与杜比全景声重构
针对影视作品复杂的声音工程环境,SMPTE 标准强制推行了‘声源自适应分离与空间混响补偿协议’。在导入原始混音轨时,系统通过高阶时频掩蔽与注意力网络,将人声对白与背景环境音、环绕立体声乐器音轨进行分子级干净剥离。在全新的多语种 AI 配音合成完毕后,系统能够根据原视频拍摄场景的物理空间尺寸(如开阔草原、狭窄地下室或大型教堂),自动对新配音的人声附加精确的空间卷积混响,并重新与原始背景音轨进行微秒级音画贴合,完美支持 Dolby Atmos 杜比全景声标准的工业化无缝输出。
三、 重构全球文化产业链:中国短剧与视听出海的生产力核聚变
SMPTE ST 2135 标准的颁布与落地,对正在全球狂飙突进的中国短剧出海产业而言,无疑是一剂极其强大的工业催化剂。在过去,一家中小型短剧出海平台每个月只能挑选极少数有望跑出爆款的剧目,耗费数周时间聘请海外草根配音演员进行手工译制;而在新一代AI配音生产线的加持下,整部数十集的短剧从中文母版到完成英语、西语、阿语等十余个语言版本的精细译制、口型匹配与全自动字幕生成,全流程耗时被缩短至惊人的数小时以内,综合本地化制作成本狂降 85% 以上。
更为重要的是,这种零时差、高品质的视听体验极大地提升了海外本土用户的观剧留存率与付费意愿。多家海外流媒体分析机构发布的最新评测数据显示,采用符合 SMPTE ST 2135 标准制作的多语种 AI 配音短剧,其海外观众单集完播率相比传统机械配音版本暴增了 3.2 倍,付费充值转化率直逼好莱坞本土中等制作水平的流媒体网剧。
国际影视工程协会技术委员会主席在白皮书发布会上感叹道:“技术的最高境界是让人感受不到技术的存在。当一部中国古代武侠剧或现代都市情感短剧通过大屏幕展现在海外观众面前,剧中人物操着纯正流利的本土语言、口型毫无破绽、情感深沉共鸣时,语言的藩篱便被彻底消融,人类文明之间最为真挚的情感共鸣得以在微秒级的声学流形中完美传递。”
推理延迟
12ms
识别精度
98.4%