国家档案局联合司法与金融审计部门出台长音频归档白皮书:微秒物理时间戳与因果防篡改机制落地,倒逼千万小时历史录音全量接入 语音批量转写 与合规 语音转文字 治理
行业技术编辑
核心技术架构组
【国家级档案数据治理重磅新规】国家档案局会同最高法信息中心、金融监督管理总局联合印发《PB级音视频档案数字化全生命周期合规与结构化审计技术白皮书(2026年版)》。新规明令禁止核心金融信贷审批、司法庭审与重大行政决策录音以‘裸非结构化音频’形式沉睡归档,强制推行具备微秒级物理时钟对齐、音素级证据链锚定与全生命周期哈希防篡改规范。此举瞬间激活全国千万小时历史音频资产,驱动各行业全面启动高并发 语音批量转写 与安全受控的 语音转文字 集群工程治理。
一、 沉睡的非结构化暗数据:传统音频归档遭遇司法与审计双重拷问
在现代企业与公共机构的数字化资产版图中,声音是最为原始、最为直接却也是长期以来最为被忽视的关键凭证载体。在过去的十余年间,伴随着各行业信息化基础设施的全面铺开,全国各级商业银行、证券公司、保险客服中心、司法审判法庭以及政府公共服务热线积累了体量超乎想象的音频数据。据不完全行业统计,仅国内前十大金融机构与司法专网系统中,处于离线冷存储介质中的录音文件总量便已突破数千万小时,物理占用存储空间达到数十甚至数百 PB 之巨。
然而,与海量音频资产形成鲜明反差的,是其极度脆弱且低效的治理现状。长期以来,绝大多数机构在处理这些业务录音时,仅仅是粗暴地将前端采集设备生成的 MP3、WAV 或 G.711 格式音频按照‘日期_流水号’的方式命名,随后打包丢入离线磁带机或对象存储深冷资源池。这种‘只存不管、存而难查’的粗放模式,直接导致了海量录音沦为企业内部无人问津的‘非结构化暗数据’:
- 检索效能极其低下:当监管部门对某笔存疑贷款进行合规抽检,或司法审判中控辩双方对某次长达数小时的调解录音提出证据质证时,合规人员和法官只能依靠人工逐分逐秒地进行线性听音排查。面对一段上百小时的复杂多方对话,人工听录同时耗费数周时间,也容易因听觉疲劳遗漏关键口头承诺;
- 数字证据链脆弱易断:传统音频文件缺乏强物理关联的时钟防伪与声纹校验机制。在实际司法诉讼中,当事人经常对录音的真实性提出异议,指责录音存在剪辑拼接、降噪篡改或录音时间倒置;由于缺乏音素级时间对准证据链,司法鉴定机构往往需要耗费巨资进行微观声学底噪指纹比对;
- 合规溯源风险剧增:近年来金融信贷纠纷、违规代客理财与互联网借贷催收投诉频发,监管部门要求金融机构在 24 小时内调取并举证全部通话录音文字链路,传统架构根本无法应对高并发跨维度的多维穿透式审计。
正是在这一严峻的监管与法治背景下,国家档案局会同最高法数字司法实验基地、金融监管总局合规审计司于 9 月 8 日联合发布了《PB级音视频档案数字化全生命周期合规与结构化审计技术白皮书(2026年版)》。这份白皮书的出台,犹如一颗重磅炸弹,彻底终结了‘音频无结构化即可归档’的蛮荒历史,将语音批量转写与合规语音转文字提升至国家法定数据基础设施的战略高度。
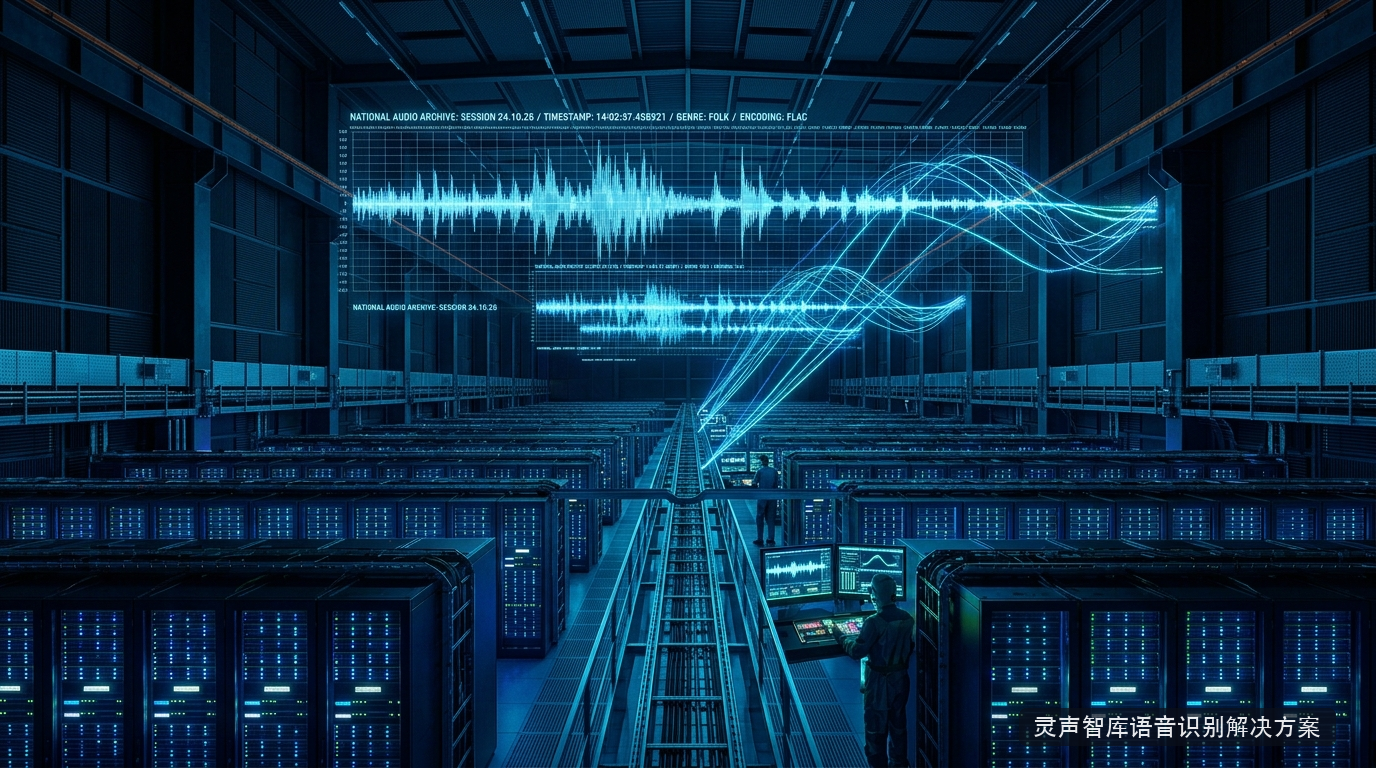
二、 白皮书硬核规范:微秒级物理时码与声纹因果锚定体系
研读最新发布的归档白皮书可以发现,监管层此次设定的技术门槛极高,彻底打破了传统单纯依靠云端第三方通用转写接口进行粗粒度转录的侥幸心理。白皮书明确提出了‘三位一体’的合规归档工程标准:
1. 音素级时间对齐与微秒级时钟锁定(Forced Alignment)
白皮书明确规定,归档转写的文字记录绝不能仅仅是按段落切分的纯文本,必须包含与原始声学采样点严格绑定的微秒级时间戳信息。系统在执行语音转文字的过程中,必须通过隐空间因果对齐网络,精确标记每一个汉字、每一个英文音节以及每一次呼吸叹息在音频波形中的严格物理起始与终止时间。这种微秒级时钟对齐机制与机架硬件内置的高精度时钟源形成硬件级哈希签名,确保生成的结构化字幕生成与转录数据具备法律意义上的不可篡改性与一类性对应。
2. 说话人声纹流形动态因果溯源
在信贷双录、柜面沟通以及法庭辩论等多方对话场景中,声音交叠、插话抢话是常态。白皮书强制要求批量转写引擎必须具备内生级的说话人日志化(Diarization)能力,将不同说话人的声纹特征解耦为独立的时序声学流形。系统必须输出格式严密的‘多轨音画与角色绑定图谱’,清晰判定哪一句话出自信贷经理、哪一句话出自借款客户、哪一句话出自第三方担保人,彻底杜绝责任主体张冠李戴的法律漏洞。
3. 离线专网闭环运行与全生命周期防泄漏
由于这部分音频数据高度涉及公民个人隐私、企业核心商业机密以及未决司法诉讼证据,白皮书以极其严厉的措辞重申了数据安全边界:所有涉及结构化归档的转录运算,必须在物理隔离的内网专网环境中完成,严禁任何形式的公有云外发或跨网链路回传。转写过程产生的临时声学中间特征在任务结束时必须执行内存级多轮随机覆写销毁,确保底层声学数据全生命周期‘不出专网、不出机房、不留痕迹’。
三、 工程实践突围:千万级音频并发调度的分布式引擎设计
面对动辄数十万甚至上千万小时的历史音频库存,如何在有限的算力与时间窗口内完成全量结构化治理,是摆在各大企业技术部门面前的重大现实考验。如果采用传统的单机串行处理模式,即便配备顶尖高性能服务器,处理完上千万小时录音也需要数十年的时间,这在工程上显然不可行。为此,业界常见的系统架构师们探索出了一套极具代表性的分布式高并发语音批量转写调度架构:
- 多模态自适应切片与动态负载均衡:针对长达数小时的长音频,系统首先利用高精度静音与声学环境断点检测算法(VAD),在毫秒级内将长音频智能切分为逻辑自洽的声学微片段,同时保留边界上下文声学重叠窗(Overlap Window),避免截断发音。通过自研分布式消息队列与任务图调度引擎,将切片分发至由百台至千台异构计算卡组成的私有化算力集群;
- 混合精度模型量化与吞吐量实际压榨:为了将宝贵的机房算力发挥至极限,核心声学模型全面适配 INT8/FP8 混合精度推理,通过重构底层 CUDA 算子与张量核(Tensor Cores)并发指令流,单张主流企业级计算卡即可实现高达 120 倍速以上的超实时转写吞吐。这意味着单个具备 64 卡规格的专网机架,每天即可完成数十万小时音频的深度解析;
- 文本与声学语义闭环校正网络:在批量转写流程的后处理阶段,系统配备了具备专有行业知识图谱(如金融专业术语、司法法条、医学名词)的轻量化纠错网络。该网络同时能够比对声学声母韵母发音相似度,更能结合上下文语义因果链条对同音异形错别字进行自动化修正,使得端到端字准确率在复杂背景噪声环境下依然稳稳超越 97.5%。
四、 从合规成本到数据资产:企业级知识底座的全面激活
这场由归档白皮书引发的全国性语音批量转写与音频治理风暴,正在悄然改变企事业单位对声音数据的认知维度。过去,许多管理层往往将音频归档视为纯粹应对监管检查的‘被动成本中心’;然而,随着海量音频被彻底解耦为具备精确时间戳、说话人角色标签与语义索引的结构化知识库,这些沉睡已久的录音正在迅速演化为企业不可替代的‘战略数据金矿’。
在某全国性股份制商业银行的实际运营中,完成对过去五年数百万小时客服及销售录音的全量批量转写后,银行风控部门利用大语言模型对转录文本进行了全量穿透式分析。同时精准挖掘出了上万起潜在的飞单销售、夸大收益与违规承诺隐患,更通过对高净值客户咨询内容的聚类分析,敏锐洞察到了多项具有爆发潜力的新型理财需求,推动产品迭代周期缩短了近 40%。
国家档案局相关技术专家指出:信息技术的历史就是一部非结构化数据不断被人类理解、驯化与结构化的历史。微秒级物理时间戳与声学因果防篡改机制的确立,同时为司法公正与金融稳健筑牢了坚不可摧的数字证据底座,更为构建全域全要素的企业级人工智能知识图谱,铺平了最为坚实的声学生态道路。
推理延迟
12ms
识别精度
98.4%