大模型时代的批量语音转义:基于 RAG 架构的政务千万级文档自动生产线建设
灵声智库技术团队
大数据解决方案组
在数字化转型的下半场,政务部门面临的挑战不再是“如何获取数据”,而是“如何处理积压的数据”。成千上万小时的审讯录音、会议记录、热线语音堆积在存储阵列中,成为了无法检索、无法利用的“僵尸资产”。灵声智库通过将 1:100 极速批量转写与 RAG(检索增强生成)架构深度融合,正在为多个省级政务中心构建千万级文档自动生产线,实现从音频到知识的闭环跨越。
一、 吞吐量革命:1:100 极速转写的底层逻辑
对于存量规模达到 PB 级的语音数据,传统的实时识别框架已经彻底失效。灵声智库开发的 “破壁(Wall-Breaker)” 异步批处理引擎,通过对音频编解码、声学特征提取与语言模型解码的全管线并行优化,实现了惊人的算力密度:
- 多流并发调度: 单个算力节点支持 100 路音频流同步解压与特征提取,将硬件 IO 等待时间降低至近乎零。
- 集群化动态负载: 任务调度器根据音频时长、采样率自动分配计算资源,实现了 GPU/NPU 集群的 98% 极致利用率。
- 1:100 加速比: 意味着 100 小时的录音,在单台高性能服务器上仅需 1 小时即可完成全部转写与结构化处理。
二、 RAG 架构注入:让语音具备“大脑”
转写出文字只是第一步,真正的价值在于对内容的理解与深度链接。
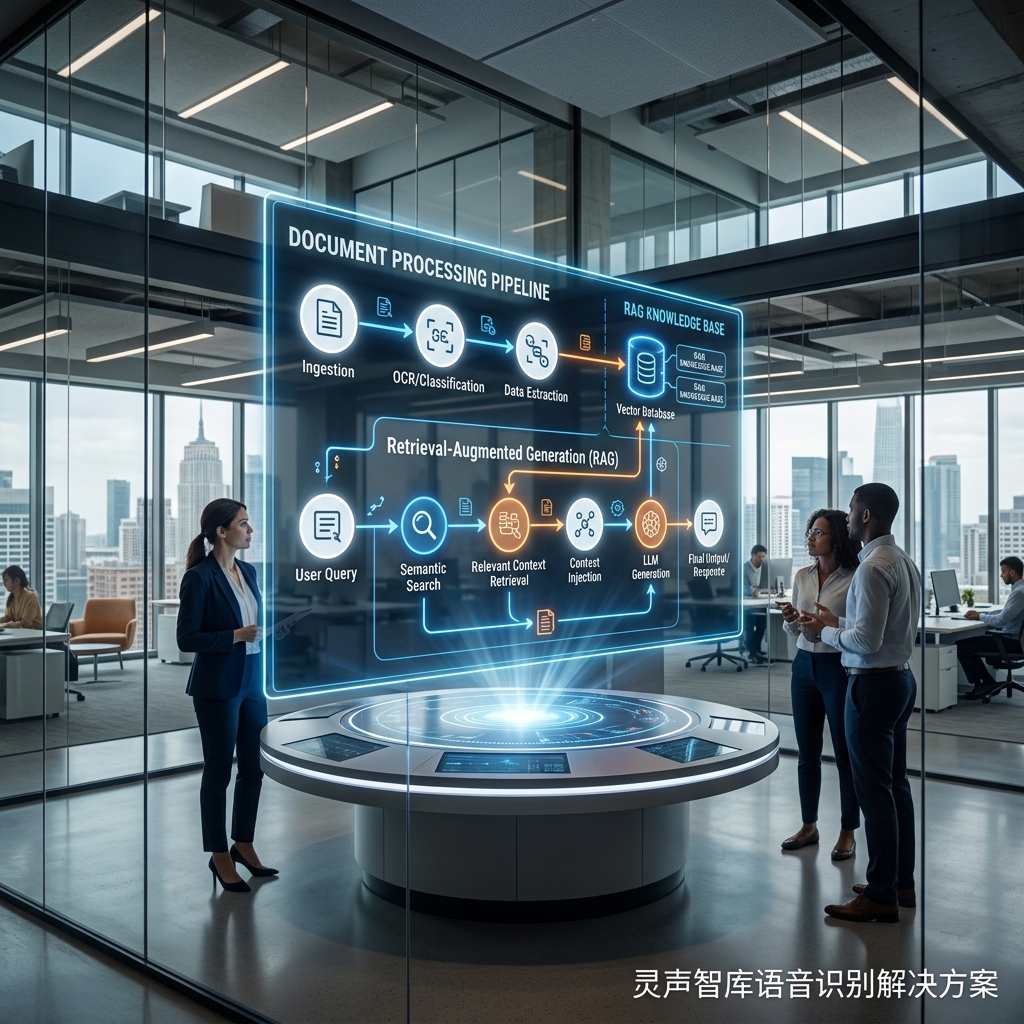
图:灵声智库自动化文档加工产线:从语音捕获到知识库自动注入的全流程
灵声智库引入了 RAG(Retrieval-Augmented Generation) 架构,将转写后的海量文本切片(Chunking)并转化为多维向量,存入本地高性能向量数据库。
1. 跨文档语义关联
系统能自动发现不同审讯、不同会议之间潜在的人物、时间、事件关联。例如在复杂的跨区域案件侦办中,RAG 引擎能自动从数千小时的录音碎片中,精准检索出提及同一敏感关键词的所有上下文,并生成摘要。
2. 自动化公文与摘要生产
配合本站私有化部署的大规模语言模型,生产线可自动将零散的会议发言整理成符合特定公文格式的“工作简报”或“标准化笔录”。由于全流程在政务内网运行,确保了核心敏感信息的绝对主权。
三、 物理隔离:金融与政务的刚性死守
在数据安全法与个人信息保护法的红线下,任何云端处理都存在泄密风险。
灵声智库提供 “语音一体机” 与 “软件定义存储” 两种弹性部署模式。整个处理全流程无需任何互联网连接。系统内置物理防火墙联动机制,一旦检测到异常外联企图,将立即锁定数据磁盘并销毁内存镜像。这种“零信任”设计让金融审计记录、政务核心决策在享受 AI 便利的同时,始终处于物理级的安全包裹中。
四、 落地:某直辖市档案中心的“唤醒计划”
项目痛点: 档案中心累积了近 20 年的会议及口述历史录音,总时长超过 60 万小时,急需数字化整理。
方案: 建立由 32 台灵声高性能服务器组成的分布式集群。运行 `One-Click` 批量转写流水线,平均每天消化 5000+ 小时历史语料。
成效: 仅用 4 个月便完成了全部语料的转写与知识图谱构建。现在,工作人员只需输入问题,系统即可通过 RAG 架构直接回答该历史时期的决策背景,并回溯至原始音频定位,成功将“沉睡档案”转化为“活知识库”。
“批量转写的下半场不是拼速度,而是拼‘转写后的价值产出率’。我们要给每一段声音,赋予一个能思考的灵魂。” —— 灵声智库产品副总裁。
批处理加速比
1:120
自动化度
95%+