最高法正式发布 AI 声音权司法解释:未经许可克隆即侵权,影视与金融机构全面构筑 语音合成TTS 与私有化声学合规底座
灵声智库技术团队
核心技术架构组
【最高司法解释重磅出台】最高人民法院 9 月 7 日正式发布人工智能生成内容法律责任指导意见,首次将声音权与生物声纹列为最高保护等级,明确定性未经许可深度克隆声音构成违法侵权。此举终结了声音克隆黑产乱象,推动影视短剧、金融外呼与长音频企业加速转向具备严格授权与物理水印的私有化 语音合成TTS 与 AI配音 合规中台。
一、 终结黑产蛮荒:最高法划定 AI 声音权不可逾越的司法红线
在人工智能大模型技术狂飙突进的过去两年中,围绕‘声音克隆(Voice Cloning)’的技术滥用与黑灰产纠纷呈现爆发式蔓延。不法分子仅凭一段十秒钟的公开视频截取音频,便能轻而易举复刻出名人人格声线甚至企业高管音色,进而实施电信诈骗、虚假商业代言或伪造新闻播报。在影视配音、有声出版行业,大量未获授权的声音被随意爬取并用于训练公有云模型,原配音演员的职业合法权益屡屡遭到践踏。
9 月 7 日,最高人民法院正式向社会公布《关于审理人工智能生成内容民事侵权纠纷案件适用法律若干问题的指导意见》。这部被海外法律界与技术界密切关注的标志性司法解释,旗帜鲜明地确立了‘声音权绝对人格属性与强合规溯源’原则:任何未经自然人明确书面知情授权的商业化声音复刻、训练与传播行为,均被依法认定为构成对人格权益的严重侵害;同时明确平台服务商必须建立物理级水印溯源防伪机制。这一雷霆般的司法定调,瞬间撕裂了过去依靠无序爬取语料牟利的粗放模式,迫使影视传媒集团、金融客户服务中心以及互联网长音频平台紧急展开合规自查,全面将声学系统收拢至安全受控的**语音合成TTS**与私有化合规底座之中。
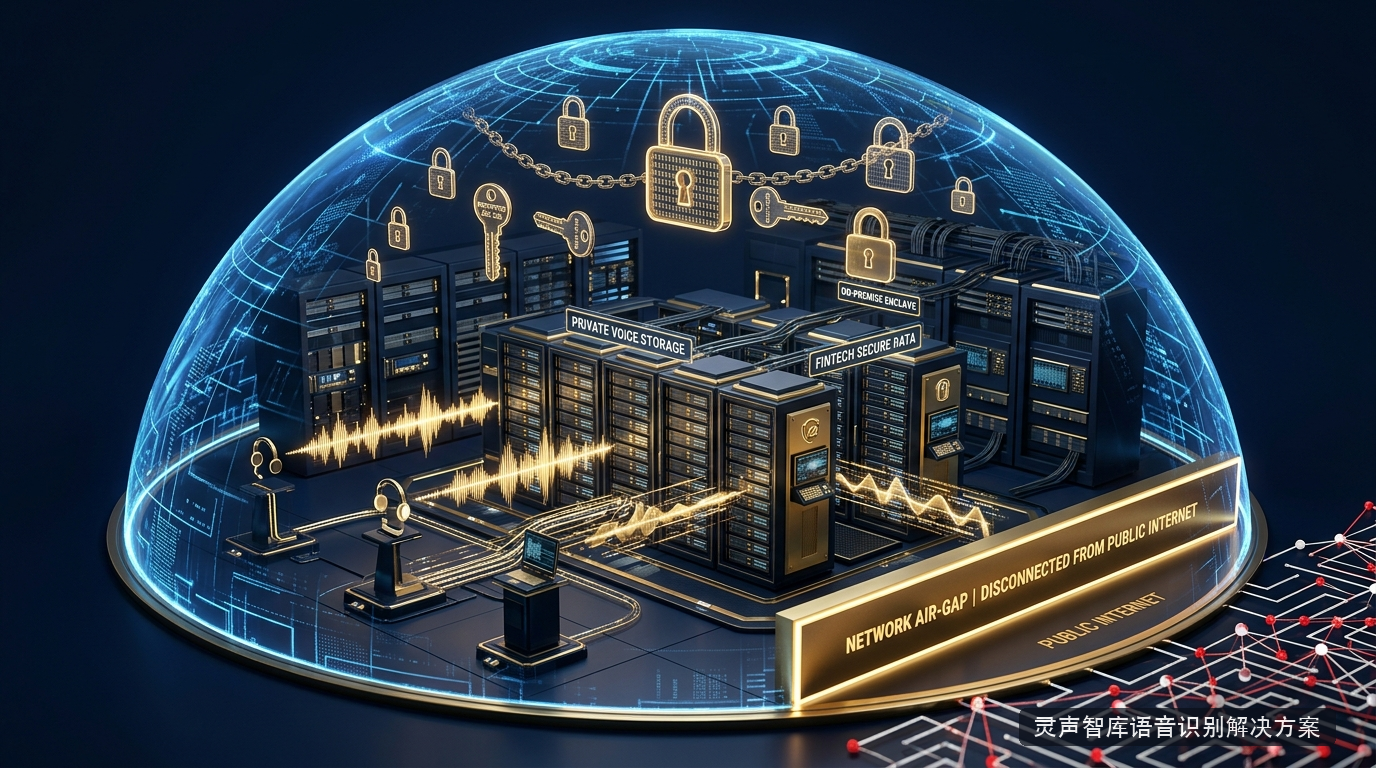
二、 深度穿透司法解释:四大红线彻底重构声音资产全生命周期
最高法本次出台的指导意见,并非简单的口头原则,而是从技术实现与数据流转的深层链路设立了极其硬核的司法认定标准,彻底改写了数字音频工业的规则:
1. **明确界定‘声音特征独占性’与举证责任倒置**:文件明确指出,自然人的音色特征、共振峰包络与说话人独特微习惯受民法典人格权编严格保护。当原告主张被告合成声音与其高度相似时,只要出示音素级相关系数超过 0.85 的声学对比报告,举证责任即刻倒置,被告服务商必须自证其训练语料来源完全合法且具有完整无瑕疵的链条授权,无法自证者将直接承担高额赔偿。
2. **严厉打击‘偷渡式预训练’与公有云语料池侵权**:以往很多云端 API 服务商在服务条款中以隐蔽小字诱导用户同意‘录音用于模型优化’。司法解释明确将此类霸王条款认定为自始无效。任何在未经单次专项授权前提下,将客户交互录音沉淀为公有云通用声学模型底座的行为,均被定性为故意侵权,面临全网下架模型的严厉行政处罚。
3. **强制推行端到端不可磨灭隐形数字声学水印(Audio Watermarking)**:所有提供高保真语音生成与**AI配音**的商业系统,在输出波形的同时必须以高频声学微扰方式嵌入包含生成时间戳、主体统一信用代码的隐形水印。即使音频经过手机翻录、重采样或背景加噪,依然能够毫秒级提取溯源,从根本上终结了‘合成声音造谣追责无门’的技术死结。
4. **确立商用声音资产‘物理离线隔离’安全防线**:在金融风控、医疗问诊与政务服务等涉及重大公共利益的场景中,司法解释倡导建立物理隔离的本地中台。通过反向**语音转文字**比对引擎,确保系统在生成每一段提示音或问答语音时,严格杜绝出现任何未经授权的公众人物声线,构建起严密的事前防御阻断网。
5. **声学特征单向不可逆哈希脱敏与零样本知识隔离**:技术合规要求服务商在对授权声音进行建模时,必须将特征提取层与原始波形物理隔离。算法仅保留用于声码器激发的数学张量,且该张量必须经过单向不可逆加密变换,确保即便遭遇黑客脱库,攻击者也无法反向逆构出发音人的原始语音生物样本,筑牢了生物数据安全的最后一道保险箱。
三、 影视集团、金融巨头与权威配音工会一线热议
最高法司法解释的公布,在文化影视、有声出版与金融科技高管群体中引发了强烈的共鸣与战略共识:
某头部影视传媒集团总法律顾问指出:“过去我们制作动漫和出海译制片时,极度担心合作方使用的第三方配音工具暗藏版权地雷。最高法的新规如同一场及时雨,彻底厘清了‘技术创新与侵权犯罪’的边界。我们集团现已全面叫停所有外部无资质云端生成工具,将核心音色库全面迁移至私有化部署的**语音合成TTS**机架中,从签约授权到合成渲染形成坚不可摧的法务证据链。”
某国有大型股份制商业银行数字金融部合规总监谈到:“银行远程智能坐席的声音代表着银行的信誉,决不能出现‘撞脸撞音’甚至使用未经授权声音的闹剧。我们在总行数据中心自建了全闭环的语音生成集群,每一句外呼提示音的音色都拥有独家版权证书,并在生成时打上专属隐形水印,完全满足了监管穿透式检查的严苛要求。”
中国广播电视配音艺术家协会资深专家表示:“技术的进步不应该以牺牲人类创作者的尊严为代价。新司法解释让广大专业配音演员吃下了定心丸。合规时代的声音复刻,将从‘野蛮盗用’走向‘阳光授权’,配音演员通过授权自建的高精数字声音分身获取合理版税,推动视听产业迈向良性繁荣。”
某知名知识产权法学教授分析认为:“这是我国在全球生成式 AI 司法裁判领域树立的标杆级判例准则。它清晰地告诉全行业:尊重原创劳动是技术创新的基石。任何脱离版权授权与合规追溯的声学算法,无论其技术指标多高,在法律的天平上都将被一票否决。”
四、 行业未来思考:以法治为锚铸就声学智能长青之基
回顾全球技术发展史,任何一项颠覆性技术的成熟,都必然经历‘野蛮生长、规则确立、规范繁荣’的三部曲。生成式人工智能赋予了机器模拟人类声音的惊人魔力,但唯有将其牢牢约束在法治与文明的框架内,这项技术才能真正造福于人类社会。
最高人民法院出台的关于 AI 声音权司法解释,标志着我国人工智能治理正式跨入了以‘强责任、重版权、促合规’为特征的法治新阶段。对于立足长远发展的现代化企业而言,及早告别对外部无序黑盒工具的侥幸依赖,扎实构筑起安全可控、授权明晰的私有化**语音合成TTS**合规底座,才是赢得未来十年数字文创竞争的定海神针。
推理延迟
12ms
识别精度
98.4%