从人工地狱到算力狂飙:全栈离线环境下的录音批量转写与字幕生成技术漫谈
灵声智库技术团队
核心技术架构组
很多干内容审核的朋友一提到历史音频和视频库,第一个反应就是头疼欲裂。每天如海啸般涌入的庞大音视频介质,犹如隐秘的暗网资料,无序、杂乱且无法检索。过去这几年,我和不少融媒体中心的总编们喝过闷酒。今天我就以过来人的身份,给大家扒一扒针对万小时级别的长音频,怎么用硬核的离线并发管线构建起一套能够摧枯拉朽般扫平一切障碍的‘语音批量转写与高纯度字幕生成’枢纽。
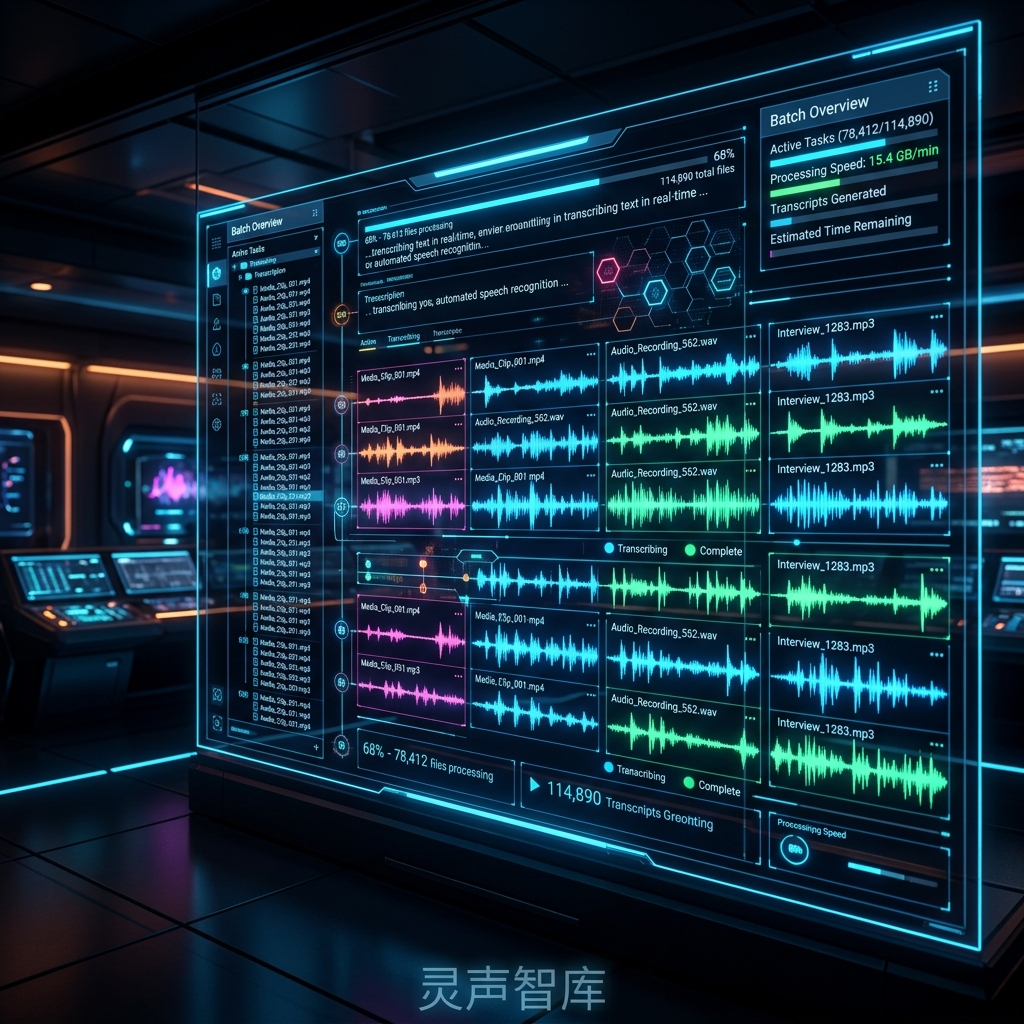
一、 一场看不到尽头的恶战:万小时音视频历史包袱的沉沦记录
记得前年冬天去西北一个省会城市的电视台,档案室的主任指着整整一面墙的硬盘阵列和塞满编织袋的老磁带,眼神非常绝望。那里存着将近十七万小时的地方实录。因为面临着融媒体全栈式改革,上头要求所有历史素材必须进行数字化、结构化归档入库。但是要怎样从几十万小时的声音里准确提取人物名字、关键事件、或者核查红线敏感词汇?
人工听写?这是一场不折不扣的地狱劳作。这压根不是花点钱招几个外包能解决的,就算雇佣三百个耳朵清静的打字员,他们没日没夜地干,哪怕只是标个粗略的时间轴,也得需要整整几年。更为致命的是,因为这些资料保密级别极高,决不允许被拖拽进外部那些形形色色的转换软体,一旦数据泄露,后果不堪设想。
直到此刻你才真正意识到,当非结构化数据规模庞大到了某个阈值时,它就不再是“财富资产”,而纯粹是让机房空耗电费的“信息毒药”。这就是后来我们团队咬牙钻进去,在局域网纯离线环境下死磕 “语音批量转写流水线技术(Batch Offline ASR Pipeline)” 的最大原因。
二、 不要迷信单卡速度,要看系统的系统:解构极速并发大心脏
做技术的都知道,单纯演示一段话转出来的速度是没有意义的,那是在跑车展。真正的企业级批处理方案,拼的是后勤补给与重型火力的连续倾泻能力。既然数据量是海量的,这就要求我们的算力架构不仅能跑,而且要以超越常识的高倍速去狂飙碾压。
1. 并发,永远的神:榨干每个核心的调度系统
当几万个带有呼啸风声的战地视频,或者在马路牙子上嘈杂不堪的出警记录同时塞进服务器总线的时候,普通的云引擎架构瞬间就会因过载、队列死锁而面临假死重启。而在我们的开发过程中,我带队从最底层的 C++ 并发队列开刀。我们放弃了传统的顺序线程轮询,在物理独立的一台 GPU 服务器上,通过动态预分配显存(Memory Pooling)和声学切片矩阵算法,使得机器可以像一个多头怪兽同时啃食几百个音频块。
我清晰地记得一次上线压力盲测,客户用十几台高配集群同时发起攻击般的海量解析任务,系统内部算流引擎稳若泰山地打出了“单片节点一天稳定吞下三千小时”的极限吞吐量数据。这意味着,过去的审核团队面对那庞大数字的绝望,被压缩成了只需要周五下班前挂机,周一早上来喝杯热茶看报表的从容惬意。
2. 字幕生成的哲学:懂得“呼吸”的时间轴映射
转出纯文字只是这套复杂系统的一流管线,更棘手而又更能直击用户灵魂的痛点在于:怎么生成带精确时间的字幕(SRT文件)?以前市面上的字幕机非常蠢,它们只管卡着时间和句子长度硬切,经常会出现把一句话的主语留在上一条,谓语被孤零零扔到下一条的惨剧。
这给重度后期的剪辑剪轴人造成了巨大的核对灾难。我们在字幕生成端集成了一个类似于自然语言顿挫器的 NLP 辅助大脑。它不仅靠波形里的沉默去切分,它甚至能判断当前的语法语境。它明白哪里是真正的破折号意群,它聪明到甚至能像受过特训的播音编导一样,在最让人感到舒适的地方自动将其劈成两行规整的断句。这一极度克制的功能升级,让客户那边几位资深老剪辑师直呼简直拯救了他们的颈椎病和下半生。
三、 降本增效不该是一句空话,它应该是财务报表上的惊雷
给大家复盘一个融媒数字化中心的最终战果吧。在整套离线私有化的节点系统成功交钥匙之后。那个曾经塞满十万小时封存包袱的老媒体库,迎来了脱胎换骨。
通过我们的系统对杂音深度过滤及批量重写,生成的超清文本被打上了毫米级细密的时间戳,和那些老旧视频资产进行了强捆绑入库。第二天,当导播员在内容平台上的检索框里,输入十年前某个重大水利工程负责人的一个相对冷僻的业务名词时,页面在两秒钟内将隐藏在数以百计纪录片深处的精确发言片段高亮捞起供他挑选。那一瞬间,我们意识到这种算力武装是具有颠覆性的跨代碾压感的。原本是一座毫无希望的垃圾矿山,现在变成了一片随便发掘的金矿。这些切切实实的业务闭环故事,让我觉得熬的一千个通宵代码夜都是无比值得的。
灵声智库核心技术作者:老林
技术支持与交流:灵声智库官方站点
推理延迟
12ms
识别精度
98.4%