流式语音合成首包慢还吞字?CosyVoice 2 与 F5-TTS 本地推理调优实测
拆解大模型实时播报中流式语音合成首包等待过长、句尾吞字与多音字误读的工程成因,对比 CosyVoice 2、F5-TTS 与 Spark-TTS 的本地推理选型与声码器调优方案。
基于自研 语音模型、核心算法与服务引擎,提供离线语音识别与文字合成能力。 具体功能、性能与部署条件以项目材料和测试结果为准。
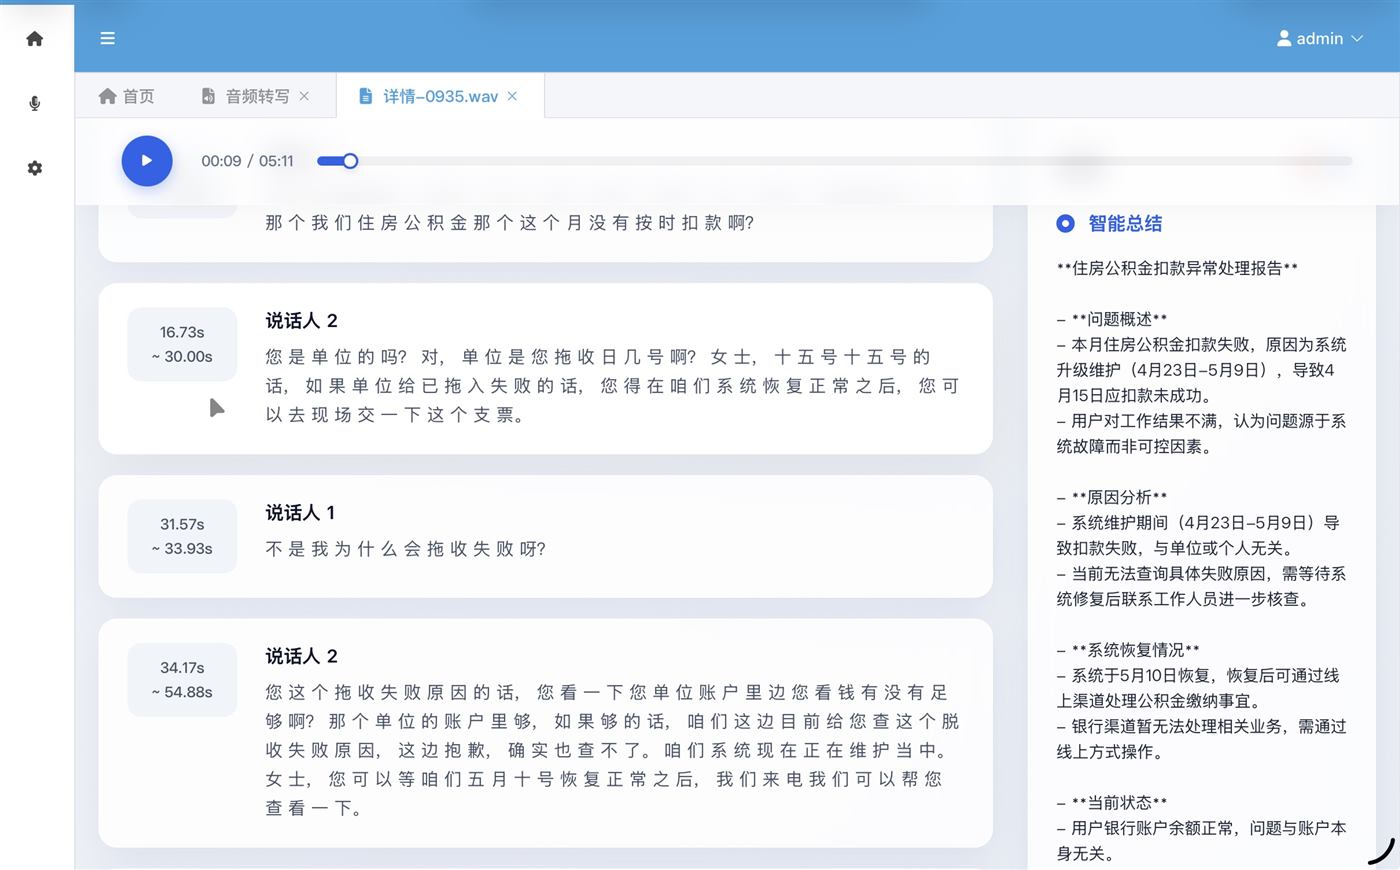
支持超大文件并行转写,内置领先的 Speaker Diarization 角色分离技术,重新定义离线环境下的生产力。
精确识别不同说话者,支持 10+ 人同场辩论识别。
毫秒级首词延迟,提供接近真人的实时反应速度。
赋予您的离线应用自然、真实的生命力。
处理千万级本地录音质检,支持实时转文字、角色分离与长语音批量识别。
仅需 5 秒样本即可高精度克隆目标音色。完全本地处理,确保声纹数据主权。
为开发者而生,通过标准 REST API 和各语言 SDK 快速集成。我们将复杂的离线语音处理能力封装为简单的接口调用。
标准 HTTP 协议交互,支持跨平台调用
C++, Python, Go 与移动端深度协议支持
import ls_ai
# 初始化极速离线引擎
engine = ls_ai.LocalEngine(
model="ling_sheng_v4",
device="local_npu"
)
# 开启角色分离语音转写
result = engine.transcribe(
audio_path="meeting_01.wav",
diarization=True
)
for speaker, text in result.segments:
print(f"{speaker}: {text}")
自动识别会议核心结论
智能标记待办事项负责人
深度解析多轮对话语境
将非结构化语音转为知识图谱
不仅是原音转录,更是深度理解。灵声智库能够自动提取长篇会议中的核心决策点与后续执行项,让音频资产真正可见、可用。
AI 系统能够自动捕捉对话中的决议点,并以高准确率自动同步至您的企业 ERP 系统。
拆解大模型实时播报中流式语音合成首包等待过长、句尾吞字与多音字误读的工程成因,对比 CosyVoice 2、F5-TTS 与 Spark-TTS 的本地推理选型与声码器调优方案。
面向政企档案库、呼叫中心与媒体资料室的海量冷音频清库需求,拆解 faster-whisper 批量推理中的复读机幻觉治理、FFmpeg 共享内存解码池与坏损流隔离方案。
针对有声书、课程制作与短剧译制中零样本声音克隆跑长文本时常见的音色变尖、房间混响泄露与机械断句问题,给出参考干声筛选、固定锚点与响度配平实操方法。
解析纪录片、公开课与出海短剧字幕自动生成中常见的时间轴漂移与断行破碎问题,拆解配乐分离、wav2vec2 音素级强制对齐与动态规划断句排版细节。
围绕政企内网与金融机构在部署 TTS私有化及高管会议语音转写时的安全合规关切,拆解纯断网容器冷启动排障、内存盘阅后即焚、声音权加密鉴权与频域溯源暗水印实操。
深入解构端到端扩散TTS如何通过解耦发音人音色与动态情感潜变量流形,攻克长篇有声书与影视配音中呼吸、叹息、微停顿等副语言真实感合成难题。
解构超大规模政企PB级存量音视频资产的高并发离线批量转写中枢,剖析异构算力DAG编排、RDMA显存直写与坏道坏流容错工程实践。
解构短剧出海中零样本跨语言声音克隆的关键瓶颈,剖析如何在英语、西语、阿语等跨语种发音体系下保持演员原生声线特质与口型情感同频。
深入剖析广播电视与流媒体工业中全自动多语种字幕生成的精度瓶颈,解构毫秒级强制对齐、背景音轨动态解耦与自适应排版换行算法实战。
在寻找行业领先的端侧离线语音方案?
我们的专家团队全天候为您解答技术构架与部署难题。
扫码开启全天候技术对接服务