几万小时历史录音怎么快速清库?语音批量转写与批量录音处理避坑指南
灵声智库技术团队
核心技术架构组
面向政企档案库、呼叫中心与媒体资料室的海量冷音频清库需求,拆解 faster-whisper 批量推理中的复读机幻觉治理、FFmpeg 共享内存解码池与坏损流隔离方案。
不少单位的存储阵列里都趴着几万乃至几十万小时的历史陈年录音:有早年呼叫中心留下的八千赫兹双声道压缩电话文件,有各地分支机构汇总上来的两小时长例会录音,还有广电媒资库里格式五花八门的采访素材。平时没人动它们,一旦赶上合规审计回溯、知识库建档或者历史档案数字化清库,需要在两周内把这批冷数据全量做完语音转文字,临时拿单机脚本硬跑的团队十有八九会熬夜救火。
很多工程师起初觉得语音批量转写很简单:装个开源的 faster-whisper,写个循环遍历目录往显卡里塞就行了。结果跑上一整晚,第二天早上一看日志傻了眼:一半进程卡死在某几个损坏的音频文件头里一动不动,另一半跑出来的文本里充斥着连续几十行一模一样的“谢谢大家观看”“请订阅频道”或者把前一句话无限循环复读,显卡利用率更是像锯齿一样忽高忽低。要把批量录音处理做成无人值守的稳健流水线,得先绕开这几个经典深坑。
为什么长录音一遇空白段就犯“复读机幻觉”
但凡用过 Whisper 系列模型处理长音频的人,多半都领教过它的静音幻觉脾气。根源出在它的预训练语料分布与自回归条件透传机制上:训练数据里包含大量网络视频字幕,遇到长达十几秒的翻纸声、键盘敲击声或电话等待音乐时,解码器没有明确人声可抓,就会顺着语言先验蹦出高频片尾套话;更麻烦的是默认开启的上下文条件透传开关会把上一窗口刚生成的错词继续喂给下一窗口当提示,一旦某处卡进重复词,后面整整十分钟都会陷入死循环。
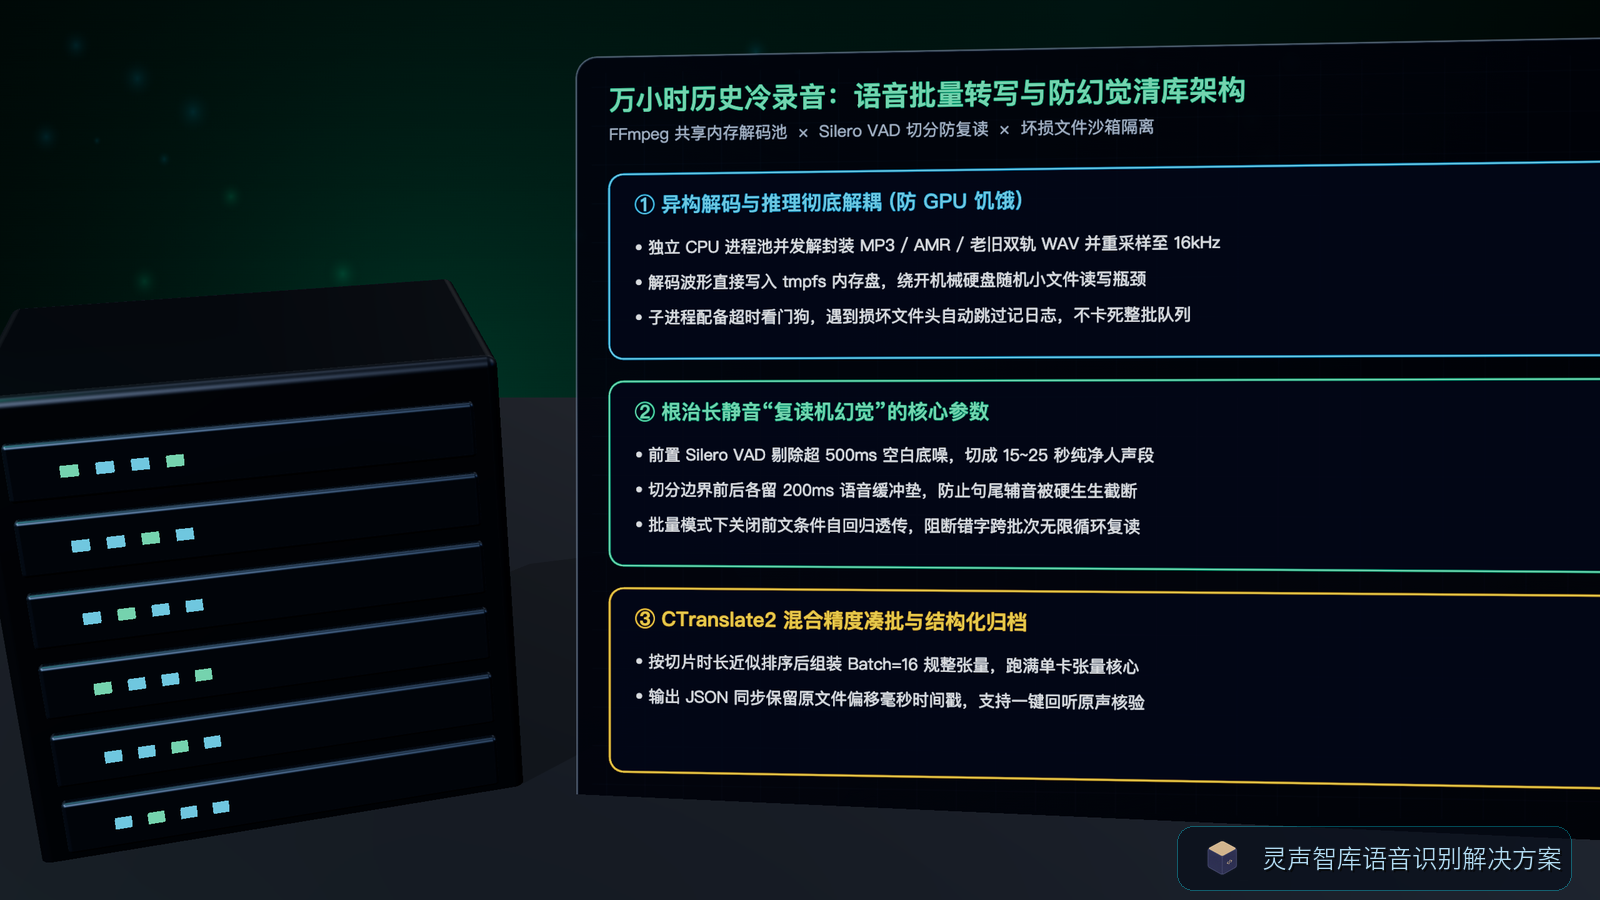
治住这毛病不能靠事后写正则删重,必须在送进声学编码器前做干净的语音活动切分。工程上成熟的做法是前置轻量级 Silero VAD,把连续超过五百毫秒的纯静音段直接剥离,只把真正有人说话的片段聚合成十五到二十五秒的紧凑音频块送去凑批推理。这里有个非常关键的微调参数:切分起止点前后务必保留两百毫秒左右的语音缓冲垫,千万别贴着能量阈值硬切,否则句首清辅音和句尾鼻音一旦被削掉半截,解码器反而会因为语义残缺去瞎猜补词。在批量清库模式下,建议果断关掉跨窗口的前文自回归透传,并配套启用压缩比异常检测门限,一旦发现单段输出字符重复率异常升高,自动降温或回退重算。
把音频解封装搬进共享内存,别让显卡等硬盘
解决了幻觉问题,接下来就是榨干硬件吞吐。基于 CTranslate2 引擎的八比特整型或半精度混合推理速度相当快,单张主流推理卡在凑够十六批大小时,每秒能吞下几十秒乃至上百秒的音频特征。这时候真正的瓶颈往往转移到了机械硬盘阵列和处理器解封装上:历史档案里大量零碎的小体积 MP3、AMR 或老旧 WMA 文件,如果让推理进程自己一边读网络挂载盘、一边调解码库转成十六千赫兹单声道波形,显卡八成时间都在干等投喂。
高吞吐清库架构一定要做读写与计算的彻底解耦。前置拉起一组纯处理器工作的 FFmpeg 独立解码进程池,提前从对象存储或挂载盘顺序预取原始文件,统一重采样为十六千赫兹单声道浮点数组后,直接写进宿主机的内存盘缓冲区,再把切片元数据推入本地消息队列。推理进程只管从内存盘里按相似时长捞取十六或二十四条语音块拼成规整批次张量,几乎消除了零填充浪费,机械盘慢速随机读写的拖累也就此迎刃而解。
坏损文件微沙箱隔离与双声道物理分轨红利
跑上百万个历史录音文件,必定会撞上录制中断导致的残缺文件头、时间戳倒退或者全零死文件。如果解码逻辑跟GPU推理跑在同一个主进程里,某条畸形音频触发底层解码库段错误,整张显卡的常驻模型就会跟着陪葬重启,来回加载权重白白浪费大把时间。务实的防线是给每个解码子任务套上十秒硬超时看门狗与独立子进程隔离,凡是解封装报错或超时的坏文件,立刻挪进异常隔离目录并记入核查清单,主干队列毫不停顿继续往前推。
遇到早期电话录音系统导出的立体声文件,记得先拿脚本抽查一下左右声道能量独立性。很多老系统天然把坐席录在左声道、客户录在右声道,这时候千万别手欠先把双声道混成单声道再去费劲区分谁说了哪句话,直接拆成左右两条独立单声道流分别送进批量队列,转写出来再按原文件毫秒偏移时间戳归并排序,角色归属天然泾渭分明。而面对大型会议室单只吊麦录下来的远场录音,主位发言人震耳欲聋、角落汇报人细如蚊呐,动态范围落差往往超过三十分贝,建议在 FFmpeg 预解码阶段顺手串入五百毫秒滑动窗口的动态音频归一化滤镜,把微弱人声温和抬升并压住拍桌削波尖峰,角落发言的漏字现象立马大幅缓解。
断点续跑幂等账本与领域专有词低成本校准
连续跑好几天的海量清库作业,随时可能遇上机房巡检断电或存储挂载闪断。千万别单纯靠检查目标文件夹里存不存在同名文本来判断是否完工,因为进程意外退出留下的半截空文件极难用肉眼挑出来。稳妥的做法是在本地建一张轻量状态账本,记录每个音频文件的哈希校验值、总时长、已产出切片数与归档状态;工作节点先把完整文本写进临时后缀文件,校验无误后再执行原子重命名改写正式结果,中断重启后几秒钟就能精准续上未完队列。
针对政企会议语音转写与客服归档里频繁冒出来的内部产品代号、机构简称和地名同音错字,批量清库阶段也没必要兴师动众去微调大模型权重:先在推理初始提示词里塞入一百多个字的核心业务词表做拼写引导,再在文本入库前挂一道基于声韵母编辑距离的词典校正脚本,仅替换发音一致且上下文词性吻合的专有词条。参考灵声智库此前整理的媒资清库工程台账,把内存盘预解码、静音预剥离、远场增益配平、双轨拆分与幂等账本这几招组合起来,两三台四卡服务器一周之内就能把数万小时沉睡录音洗成干净可查的结构化文本库。
建议切分窗口
15~25s
微批并行规模
Batch 16