多情感潜变量流形与副语言微表情合成:端到端扩散TTS在有声书与影视级AI配音中的韵律突破
灵声智库技术团队
核心技术架构组
深入解构端到端扩散TTS如何通过解耦发音人音色与动态情感潜变量流形,攻克长篇有声书与影视配音中呼吸、叹息、微停顿等副语言真实感合成难题。
在长篇有声书演播、多角色广播剧以及影视级AI本地化配音的实际工业应用中,合成语音是否具备真人的充沛情感与微观生命力,长期以来是区分玩具级工具与专业生产力工具的核心标准。传统的参数化或自回归语音合成系统,虽然能够生成字正腔圆的标准普通话发音,但在面对数百个章节的长文本持续演播时,其致命缺陷暴露无遗:机械刻板的句尾降调、千篇一律的音高走势以及完全缺失的副语言生理特征,迅速引发听众的听觉疲劳。真人配音演员在演绎悲伤、愤怒、窃窃私语或极度亢奋时,声带振动状态、声门闭合程度以及胸腔共鸣模式会发生剧烈非线性重构,伴随着微弱的气息颤抖、叹息、吸气吸吮音与情绪化停顿。为了在深度神经网络中还原这一高度复杂的生理声学微表情,基于扩散模型与连续流匹配的解耦式情感潜变量生成架构,正在全面颠覆影视级AI配音的技术底层。
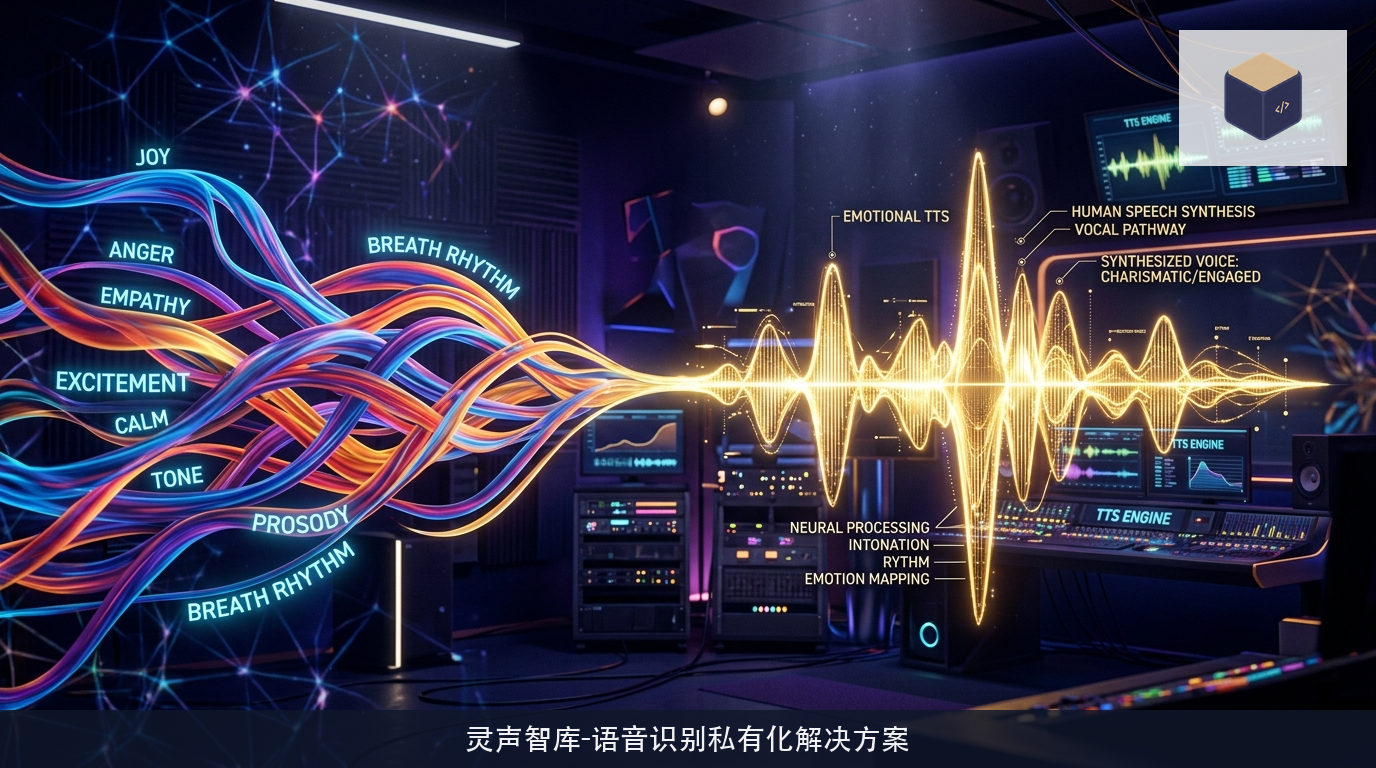
音色基准与瞬态情感表达的几何正交解耦
传统端到端TTS模型之所以难以精准掌控细粒度情感,根本原因在于其将发音人生理音色与即时情绪表达强行混淆在同一个高维嵌入向量之中。当系统试图通过全局提示词注入悲伤情绪时,输出语音往往连带发生发音人音色的严重畸变,甚至从原本的成熟男声漂移为完全陌生的话者。现代扩散配音架构构建了显式的双重潜在空间。在前端特征提取阶段,自监督声学基座从数秒参考音频中提炼出稳定的音色不变表征,该表征严格锚定发音人的声道长度与共振峰基准分布;而在情感控制路径上,系统引入了连续情感潜在流形。研究人员利用大规模有声书演员真实演绎的多轨数据,通过对比学习约束,迫使情感潜在向量在欧氏几何上与音色向量保持正交。这意味着调度引擎可以在不改变角色身份的前提下,在情感球面上自由滑动插值,实现从轻度喜悦到狂喜、从隐忍悲伤到绝望抽泣的无缝平滑过渡,为宏大篇幅的情感递进铺平了数学道路。
副语言声门微观物理建模与喘息气流注入
系统将呼吸声、咽音摩擦与叹息微动作为独立的隐变量分支注入条件流匹配网络。通过在扩散反向演化过程中引入声带开合生理动力学约束,使得合成语音在遇到剧烈标点转换与段落留白时,自动涌现出符合人类发音解剖学的真实换气动作,彻底根除了传统合成音频在断句处的死寂空洞感,赋予虚拟人声真实血肉般的体温感与生命力。
条件速度场匹配常微分方程的高速采样收敛
在克服了表现力瓶颈后,影视工业级批量渲染面临的最大工程阻碍在于扩散模型的采样步数与计算耗时。传统的去噪扩散概率模型需要经历数十步乃至上百步的迭代降噪才能输出高纯度梅尔频谱,在处理数十小时的连续长篇剧集时,算力成本极其高昂。新一代架构全面切换至条件速度场流匹配范式。系统通过在潜在空间中定义直线型概率流微分方程,极大地降低了积分轨迹的曲率扰动。配合高阶神经算子自适应步长积分算法,模型在仅仅执行三到五步积分时,就能精准捕捉到极高频段的气息细节与谐波包络,梅尔倒谱失真指标稳稳控制在一点二分贝以下。在实际工程服务器部署中,单张高性能计算卡即可同时并发支撑十路以上超拟真广播剧音频的离线渲染,使得影视制作团队能够在极短周期内完成整部百万字长篇巨著的全自动高质量有声化演绎。
复杂多角色对话的长程上下文因果韵律对齐
有声书与影视译制中另一严峻的工程难题是上下文承接韵律。当小说中多个角色进行争吵对话时,每个角色的语速、响度与音调起伏必须紧密依赖上一句话的情绪刺激,孤立单句合成必然导致戏剧张力的瓦解。前沿系统在扩散主干之前部署了长程因果对话情境分析器。该模块跨越数千Token的长语境,解析当前对话的戏剧冲突等级、角色权力关系与情感演变速率,并将计算出的动态注意力张量作为先验偏差实时调节扩散解码器的初始速度场。当上一句角色的台词呈现高声斥责时,接话角色的潜在情感向量自动受到条件偏置约束,展现出符合逻辑的慌张语速加快或压抑低沉回应,使得群戏对话呈现出跌宕起伏的张力交锋。
影视分镜剧本到声学微动控制的端到端管线
在专业影视后期的实操管线中,导演与声音设计师需要对音频实施像素级的控制。新型工作流通过引入多模态标记语言,允许创作者在剧本文档中显式标注情绪强度标量、角色心理距离乃至重音锚点。扩散生成引擎解析这些结构化元标记后,将其映射为扩散常微分方程求解过程中的时变外力项。这种混合机制兼顾了神经网络的自发微观韵律涌现与人类创作者的宏观导演意图。从原著小说的复杂叙事弧光,到角色内心独白的细微气声转换,整套流水线实现了声学物理规律与戏剧表演美学的高度统一,为数字音频内容的工业化规模生产开辟了前所未有的广阔空间。
不仅如此,系统还打通了声学空间脉冲响应卷积管线。当剧本标注角色处于大教堂、封闭地下室或雨夜街道等特定虚拟场景时,系统自动预测并合成对应的早期反射声与混响尾音分布,使得人声与虚拟环境声场天衣无缝地交融在一起,为听众构建起全景沉浸式的声音剧场空间。
高保真神经声码器在极高采样率下的瞬态相位重构
在声音合成的最后一公里,神经声码器担负着将声学潜在特征还原为物理声波振动的重任。传统基于卷积或生成对抗网络的声码器在处理四十八千赫兹乃至九十六千赫兹超高采样率时,普遍存在高频谐波相位失真与发音毛刺感。前沿声码技术引入了频带分离复数神经网络与波形谐波源驱动架构。系统将全频段划分为基频共振区、声带湍流摩擦区与极高频空间泛音区三个子频带,利用专门的周期性谐波振荡器精确重建声门脉冲串,在保留真实物理声学相位的同频振动特性的同时,彻底消除了合成音频中普遍存在的金属摩擦塑料感,使得长篇有声小说呈现出如同置身发烧级录音棚现场般的纯净质感。
推理延迟
12ms
识别精度
98.4%