零样本AI配音为什么越听越假?长文本声音克隆抗音色漂移与干声清洗评测
灵声智库技术团队
核心技术架构组
针对有声书、课程制作与短剧译制中零样本声音克隆跑长文本时常见的音色变尖、房间混响泄露与机械断句问题,给出参考干声筛选、固定锚点与响度配平实操方法。
用过零样本声音克隆工具做课程旁白或有声书的创作者,大多经历过这种落差:挑一段五秒钟的原声喂进去,试听头两句短文案时真能让人惊出一身冷汗,齿音和鼻音像极了本人;可一旦把三千字的长篇讲稿丢进去批量生成十分钟音频,听着听着味儿就不对了。念到第三段开始语速越跑越快,嗓音莫名其妙往上发飘变尖,背景里还隐约带着一层像躲在瓷砖浴室里说话的空洞金属回音。
先把预期摆正:如果是给品牌形象宣传片录三十秒重头戏,或者需要大哭大笑、极具戏剧爆发力的角色台词,直接请专业配音演员进棚实录依然省事又出彩,没必要拿算法跟人类演员的临场张力硬碰硬。AI配音真正发挥威力的主场,是日更几十集的知识科普课件、百万字网文初版演播、多语种短剧出海译制以及博物馆多展厅导览词更新。要把长篇克隆配音做出耐听的质感,七成功夫其实花在参考干声挑选和跨段落锚点控制上。
参考干声里的一点小混响会被放大十倍
为什么短句听着还行、长句却全是塑料混响味?这跟当下主流的流匹配与自回归声学解码机理直接相关。不论是 CosyVoice 2、Fish Speech 还是 IndexTTS,模型在零样本推理时并没有真正理解“哪部分是人的声带特征、哪部分是会议室玻璃墙反射回来的回音”,而是把你喂进去的那六秒参考音频连同它的参考文本一起当成声学条件先验,顺着参考音频的频谱包络往下续写。
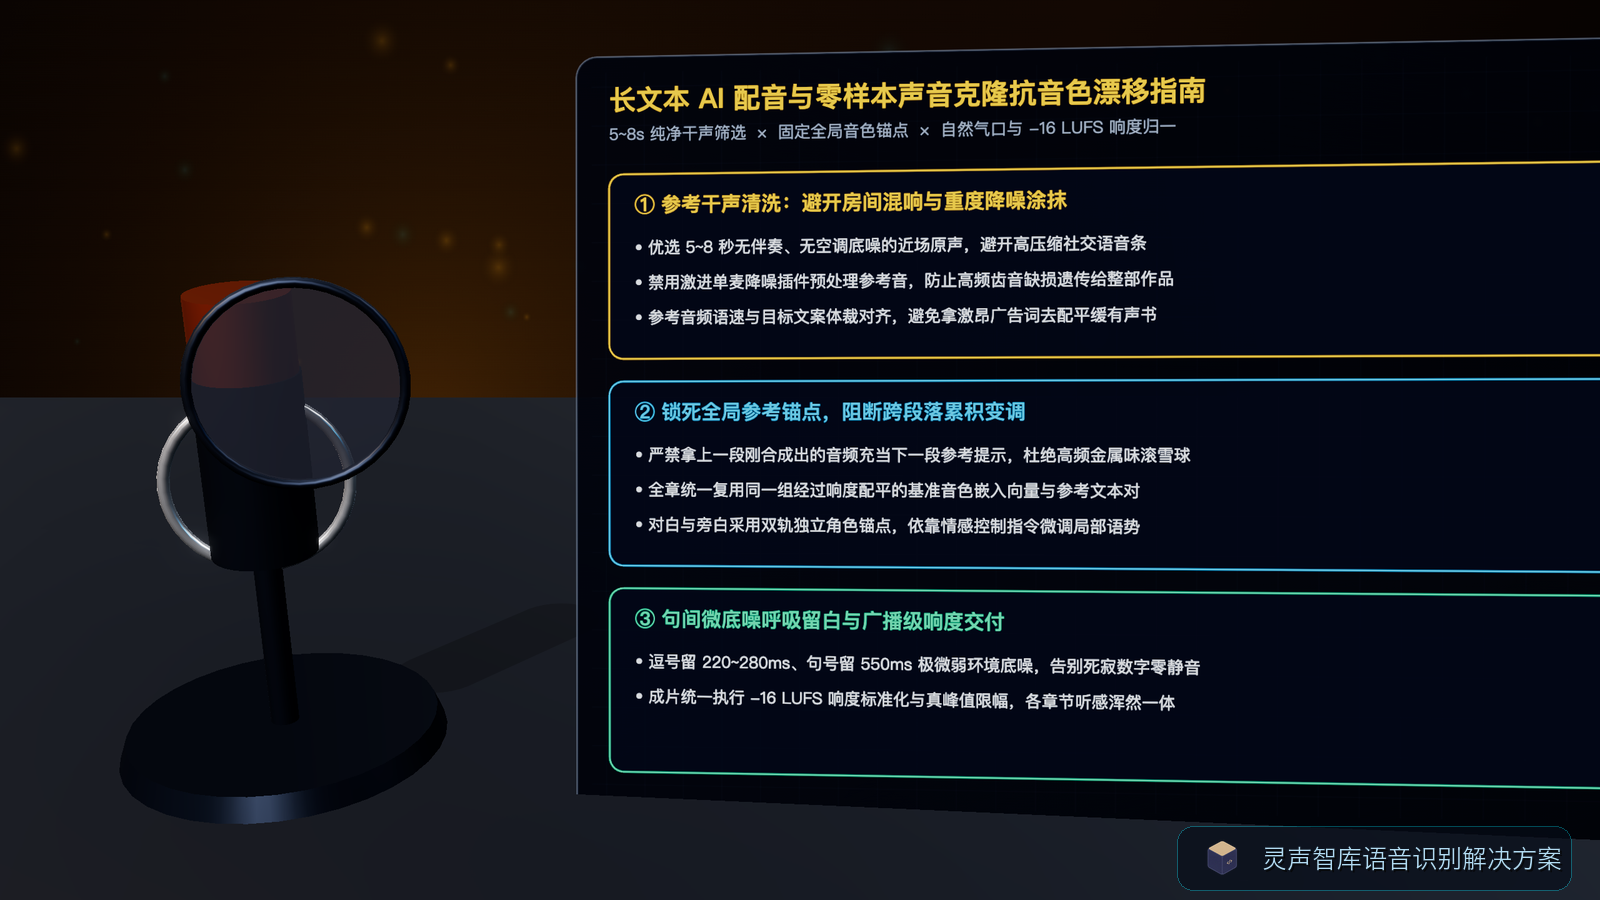
很多项目组随手从微信语音条、线上会议录屏或者带背景音乐的采访视频里截一段话当参考源。这类音频本身经过了有损窄带压缩,或者在挑出来之后又被工程师用激进的神经网络降噪软件猛洗了一遍,高频摩擦音早已被削得残缺不全。拿这种“带伤干声”去驱动语音合成,解码器每生成一句就会把高频相位残缺当成目标音色特征忠实复刻一遍。正确的干声采集规矩很朴素:在安静小房间里离指向性麦克风十五到二十厘米,录五到八秒吐字平实、不带夸张尾音的无压缩波形,只做温和的高通滤波切掉八十赫兹以下的空调低频震动,千万别挂重度降噪插件涂抹人声频谱。
严禁链式滚动参考,锁死全局基准锚点
长文本越念越飘的第二个祸首,是不少自动化配音脚本里写错了上下文衔接逻辑。有些开发者为了让上下两段语气连贯,自作聪明地把“上一段刚合成出来的音频末尾”裁下来,充当下一段推理的参考提示音。这在信号处理上相当于把录音带翻录了二十遍:每一轮微小的声码器高频失真和语速偏差都会被下一轮继承并放大,传到第十段时音色早已面目全非。
稳妥的工业级流水线会严格执行“全局锚点锁定”:整部有声书或整门课程从头到尾只认准经过人工精挑细选的那两三条原生干声样本库。比如给同一位讲师提前准备“平缓叙述”“重点强调”“提问互动”三条各六秒的原生干声锚点,无论脚本切分出五百个还是两千个自然段,每次调用自研语音模型或开源推理接口时,始终只从这三条干净原声里按句型挑一条做条件输入,从根子上掐断跨段误差累积。若是制作双人商业对谈或多人有声剧,还可以为每位角色建立四档情绪参考矩阵,并在后期混音时给主持人和嘉宾分配微弱的左右声像偏置与统一早期反射空间,让听众凭耳朵就能分辨交谈方位,彻底告别单调的念稿感。
中英混读边界平滑与回环转写自动抽检
做科技评测、商业分析或编程培训课件时,讲稿里免不了夹杂大量英文缩写与专业代号。不少零样本 TTS 模型一撞上中文汉字与大写英文字母紧挨着的边界,就会出现半秒钟的莫名卡壳,或者把本该逐字母拼读的接口缩写硬生生念成古怪的连读假词。送进合成器之前,建议用预处理词表把逐字母发音的缩写拆开插入半角间隔或直接替换为国际音标序列,把需要整词连读的英文单词统一转为标准小写,并在中英文切换处补入极短的韵律停顿标记,跨语种过渡立马顺滑许多。
面对一次生成几十万字的有声课程,靠人工从头听到尾挑错根本不现实。省力的工程办法是在配音渲染队列后面紧跟一个轻量级语音识别校验器,把刚出炉的克隆音频重新转成文字,跟原始台词逐句比对字错率与每秒语速波动。凡是回环对比发现漏字、多字或语速异常飙升的句子,脚本自动换一组随机采样种子重算两遍并择优留存;倘若三次重算仍未达标,再把该句高亮推送到人工审听网页,一位后期编辑十分钟就能修完一小时成片的全部瑕疵点。对于需要反复出现的专有术语或古诗词人名,还可以在角色管理后台维护一份按项目生效的发音锁定表,让整季上百期节目的读音口径保持高度一致,不会出现上一集念甲音、下一集念乙音的低级穿帮。
用微弱房间底噪替代死寂静音,配平全片响度
哪怕单句合成质量再高,如果直接用纯数字零值把几十个句子硬拼成十分钟长音轨,戴上耳机一听照样露怯:说话时有一点自然气息,一到句号停顿处耳朵里突然变成真空般的死寂,下一句开口又猛地炸出来,听感非常割裂。老练的音频后期脚本会在整轨底部铺一层负五十五分贝左右、人耳几乎察觉不到的干净录音棚环境底噪,并按标点符号动态控制气口时长:顿号停一百八十毫秒,逗号停两百六十毫秒,句号留五百五十毫秒,段落换气处再轻轻叠入一丝自然的微弱吸气声。
收尾出片前还有一道必做工序:响度标准化。神经网络对不同长度句子的能量分配偶有起伏,直接交付容易出现前一句轻、后一句响。正如灵声智库在多语种课程配音交付规范中反复强调的那样,成片落盘前统一用双通道动态压缩与响度均衡滤波器把整轨积分响度校准到负十六响度单位,把真峰值压在负一分贝以下,做出来的长音频放进车载音响或手机外放里,耐听度立马跟粗糙拼接拉开代差。
参考干声时长
5~8s
成片响度基准
-16 LUFS