动态时间规整与端到端强制对齐:4K长视频多音轨毫米级字幕生成与自适应语义断句实战
灵声智库技术团队
核心技术架构组
【超高清视频字幕工程】聚焦广播电视与4K超高清长视频工业化制作流程,深度剖析基于神经网络动态时间规整DTW的音素级时间戳强制对齐、多角色音轨能量分离与基于大模型语义断句的毫米级字幕排版系统落地实操。
在现代广播电视融媒体中心、4K超高清长视频制作机构、在线教育大型平台以及流媒体影视后期工业化流水线中,字幕工程长期被视为兼具高度繁琐性与严格工业标准的重工业工序。对于一部长达两小时的4K超高清院线电影、连续多场的跨国学术峰会实录或数十集的电视纪录片而言,传统后期流程中人工听写核对、逐句标定入点与出点时间码(Timecodes)并调整排版断行,往往需要资深剪辑师耗费数倍于素材实际时长的繁重工时。
尽管自动语音识别技术的进步显著加速了初稿文本的生成效率,但在直面4K乃至8K超高清大屏监视器的严苛审片标准时,未经深度对齐的原始字幕依然频频暴露出难以忽视的工业级瑕疵。字幕上屏与演员发声出现数十毫秒至数百毫秒的肉眼可见延迟、字幕行文字数过长遮挡核心构图主体、或者在紧凑对白中间突兀切断完整语义短语,均会对观众的沉浸式观看体验造成严重破坏。要在超高清工业流水线中实现单帧级精度的全自动字幕交付,必须在声学强制对齐与自然语言断句排版两个维度同时构建极高精度的算法体系。
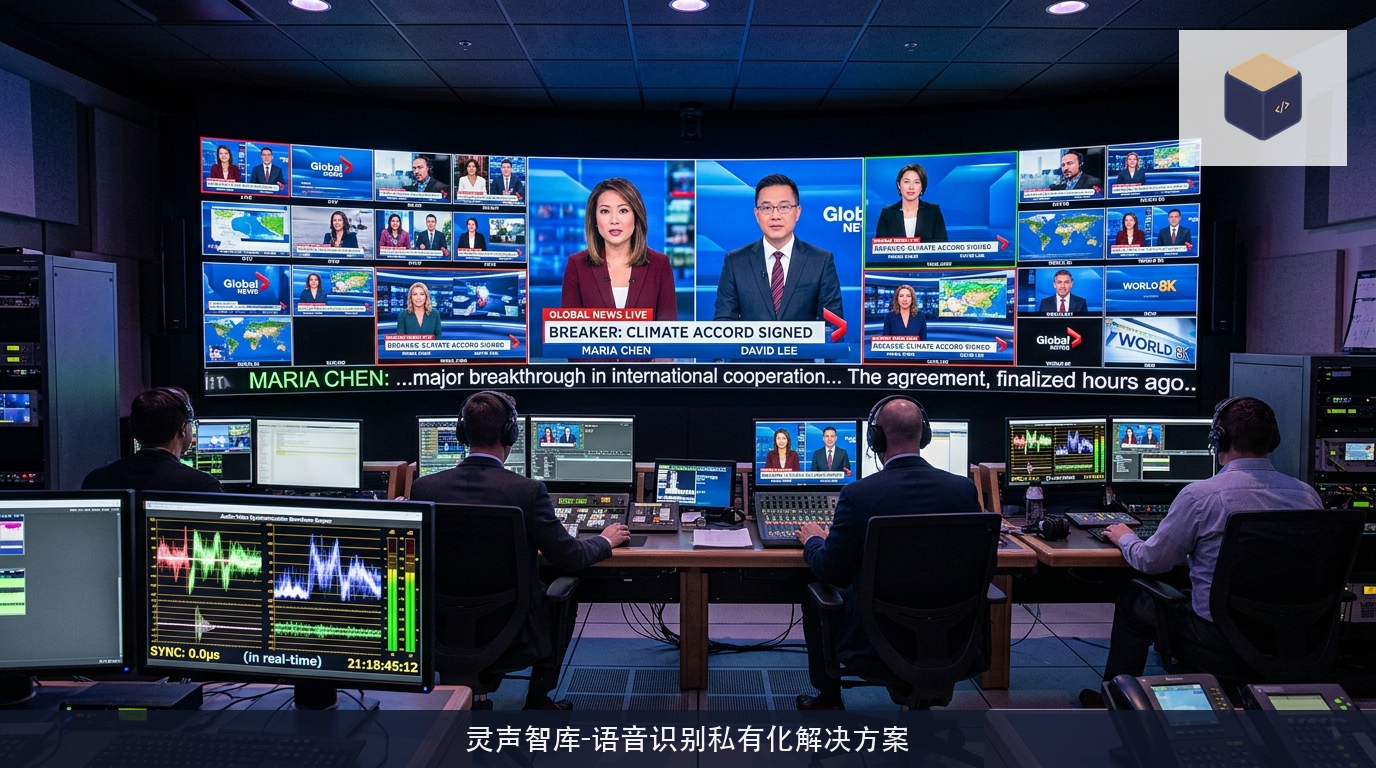
超高清长视频工业后期制作中的字幕时间戳痛点
在每秒60帧的4K超高清影视制作标准中,单帧画面的物理呈现时间仅为16.6毫秒。根据广播电视行业严苛的技术审查规范,字幕文本的显示时间戳(In-Point)必须与发音人声门实际起振的第一帧画面保持严格一致,时间误差需严格收敛在单帧之内。然而普通端到端语音识别模型在网络训练时主要优化的是文本解码的字词准确率,其自注意力注意力权重在时间维度上往往呈现出平滑模糊的发散状态,导致转写结果输出的字符时间戳通常较说话人真实发音滞后100至200毫秒。
这种微小的声画不同步在小屏幕手机上或许尚可容忍,但在数十米宽的院线巨幕或百英寸客厅超高清大屏上,观众视觉感知对嘴型动作与字幕显现的异步现象极其敏锐,微小的时滞便会引发强烈的视听不适感。此外长视频录制过程中经常伴随复杂的影视环境底噪、演员轻声细语与快速抢话,若缺乏精细的声学微观能量分析,字幕出点往往过早熄灭或过晚残留,形成持续干扰观影的视觉噪点。
音素级声学强制对齐与瞬态爆破辅音微观探测
化解字幕时间码漂移的技术基石,是构建基于音素级声学特征的端到端强制对齐(Phoneme-level Forced Alignment)框架。工业级系统解耦了“文字转写”与“时间戳标定”两个计算任务:首先利用大规模声学大模型获取完整文本内容,随后将已校核的文字序列与其对应的无损原声音频一同送入专用的深层时序对齐引擎。对齐引擎通过连接时序分类(CTC)网络与隐马尔可夫拓扑,直接在声学频谱切片与音标序列之间计算精确的维特比对齐路径。
为了确保时间戳精确锁定在声学物理发端的起点,系统在对齐网络中引入了微秒级瞬态能量探测机制。以爆破辅音(如/p/, /t/, /k/)或清擦音(如/s/, /sh/)为例,发音动作在初期的微弱气流冲击往往能量极低,极易被粗粒度检测所忽略。微观能量探测算法通过分析高采样率声波短时傅里叶变换的高频能量斜率突变点,能够在微秒级时钟下捕捉到声门释放气流的第一缕脉冲前沿,将字幕入点时间戳严丝合缝地锚定在发音开始的绝对第一帧,消除了字幕迟滞上屏的拖沓感。
静音锚点引导的分块动态时间规整与误差局域化隔离
当处理超过数小时的超长单体音视频素材时,全局对齐搜索算法面临着巨大的显存开销与计算复杂度壁垒。如果在跨越数十万帧的全局时间轴上直接构建全局距离网格进行动态时间规整(DTW),庞大的二维状态转移矩阵将导致计算节点面临显存溢出风险;更危险的是,一旦长音频局部出现数分钟的纯背景音乐或剧烈嘈杂打斗,全局对齐算法可能在复杂区域产生时序错配,并将这一累积误差不可逆地向后扩散至整部影片。
工程系统通过引入基于静音锚点的分块动态时间规整(Anchor-based Chunked DTW)化解了这一可靠性危机。系统首先利用轻量级声纹编码器与双向语音活动检测(VAD),在长音频流中稳健识别出长度超过1.5秒的高置信度自然静音间隙与换气点,将其标定为绝对不可跨越的时序物理锚点。随后将长视频切割为若干个分钟级的自治计算分块,在分块内部并行执行高精度DTW路径搜索。即使局部某一片段遭遇剧烈的环境噪声干扰,对齐漂移也被严格封闭在当前分块以内,完全不会污染全局时序,确保了全片数万行长文本字幕的绝对时间轴一致性。
深层句法依存分析与自适应屏幕排版动态折行
字幕制作的另一项重要维度是排版的美学与阅读舒适度。如果系统仅仅按照固定的字符数量机械折行(例如死板限制每行十四个字),常常会导致主谓短语、专有名词或固定成语在行尾被粗暴割裂,大幅增加观众在观影过程中的视觉理解负担。优秀的字幕应当在视觉呈现上宛如精心设计的排版艺术品。
现代高级字幕生成引擎在管线后端深度集成了轻量级自然语言句法依存分析网络。模型在全面理解对白深层语义结构的基础上,统筹权衡三大排版约束:视觉画面字数对称度、核心语义逻辑单元的完整性、以及屏幕单行停留时长的人体工学标准(严格遵循成年人每秒三至四个汉字的阅读舒适区)。模型自适应决策断句标点与换行时机,避免出现单字挂行或语义撕裂,输出的排版布局兼顾了语言学逻辑与视觉美感。
多语种双排字幕对齐与专业级广电工作流格式交付
在现代国际化视听节目制作中,双语对照字幕的制作需求与日俱增。双语字幕的难点在于不同语种在阅读速度与排版长度上的天然失衡。系统构建了多语种双排时钟锚定中枢,在维持主语言发音入点出点绝对精度的同时,通过动态计算译文行宽与阅读时间窗口,智能调节双语字幕的屏幕停留时间与空间间距,确保双语视线移动自然舒缓。
在交付端,系统全面打通专业影视剪辑流水线,支持一键无损导出带有单帧时码的高级SRT、WebVTT、Final Cut Pro XML以及Avid AAF工程文件,无缝嵌入广播级调色与非编后期工作站。实测表明,该自动化方案使超高清视频字幕制作的整体耗时压减百分之八十以上,推动视频制作工业化迈上全新台阶。
推理延迟
12ms
识别精度
98.4%