长视频字幕自动生成总慢半拍?WhisperX 强制对齐与语义断句算法拆解
灵声智库技术团队
核心技术架构组
解析纪录片、公开课与出海短剧字幕自动生成中常见的时间轴漂移与断行破碎问题,拆解配乐分离、wav2vec2 音素级强制对齐与动态规划断句排版细节。
剪辑师和课程后期团队对自动打轴工具往往又爱又恨:用语音转文字把一小时访谈或公开课的台词扒出来只要几分钟,可导成 SRT 字幕文件拖进剪辑软件轨道里一看,时间轴经常慢半拍或者快半拍。尤其是片头刚起背景音乐、或者嘉宾停顿换气的时候,前一句字幕赖在画面上迟迟不消失,后一句台词已经说了一半字幕才姗姗来迟;更让人抓狂的是断句毫无章法,一会儿一行塞满三十五个字横跨全屏,一会儿又把一个完整专有名词劈成上下两截,人工拉轴改断行的工夫快赶上手敲了。
为什么通用识别模型直接吐出来的时间戳不够准?因为编码器解码器架构预测整句起止时间令牌时,注意力机制看的是三十秒粗粒度窗口,一旦窗口里混入管弦配乐、掌声笑声或者长静音,边界注意力很容易被背景声响拽偏半秒到一秒。要想把字幕自动生成打磨到直接上屏交付的水准,必须把“认出字”和“钉准每一帧时间”拆成两步专职工序。
用音素级 CTC 强制对齐把每个字钉在声波瞬态上
目前工业界解决字幕漂移的主流开源范本是 WhisperX 这套两段式管线:前段只管发挥大模型的语言理解优势把整段话准确转成文字,完全不采信它自带的粗略字级时间戳;后段单独拉起一个基于 wav2vec2 架构、以连接时序分类损失训练出来的轻量音素对齐模型。由于对齐模型每二十毫秒就输出一帧密集的字符声学概率矩阵,配合已知转写文本跑一遍维特比强制路径搜索,就能把每一个汉字或英文单词的发声起止时刻精确卡在正负四十毫秒以内,跟二十五帧或六十帧视频的画面切镜点严丝合缝。
在落地这套强制对齐算法时,有两个极易踩中的工程暗坑。头一个是采样率陷阱:视频成片音轨大多是四十八千赫兹立体声,如果提取特征前漏了重采样步骤,或者左右声道反相抵消了人声,强制对齐矩阵会出现整段错位,导致整排字幕在屏幕上毫秒级一闪而过,必须严格在入口处转成十六千赫兹单声道无损流。第二个是数字与生僻符号失配:转写文本里的阿拉伯数字“2026”在音素模型眼里没有对应声母韵母,对齐前得先过一遍数字转汉字发音映射,对齐算完时间戳后再把显示文本还原回阿拉伯数字,遇到无法对齐的语气助词则按相邻字时长做线性插值兜底。
还要留意强制对齐的一个先决条件:喂给对齐器的文字稿本身不能整句漏词。倘若前段识别把嘉宾连读吞音的专业术语漏听了五个字,维特比搜索为了硬凑路径,会把邻近字词的时间格拽得严重变形。处理学术讲座或医学科普视频时,建议提前抽取课件讲义里的专有名词作为热词喂给前段识别,并在强制对齐后扫描每个字的声学置信度得分;凡是单字对齐得分跌破警戒线的区间,通常对应现场抢话、咳嗽掩蔽或严重口误,脚本可直接在导出的剪辑时间线上插一枚彩色标记锚点,引导审校人员精准定位复查。
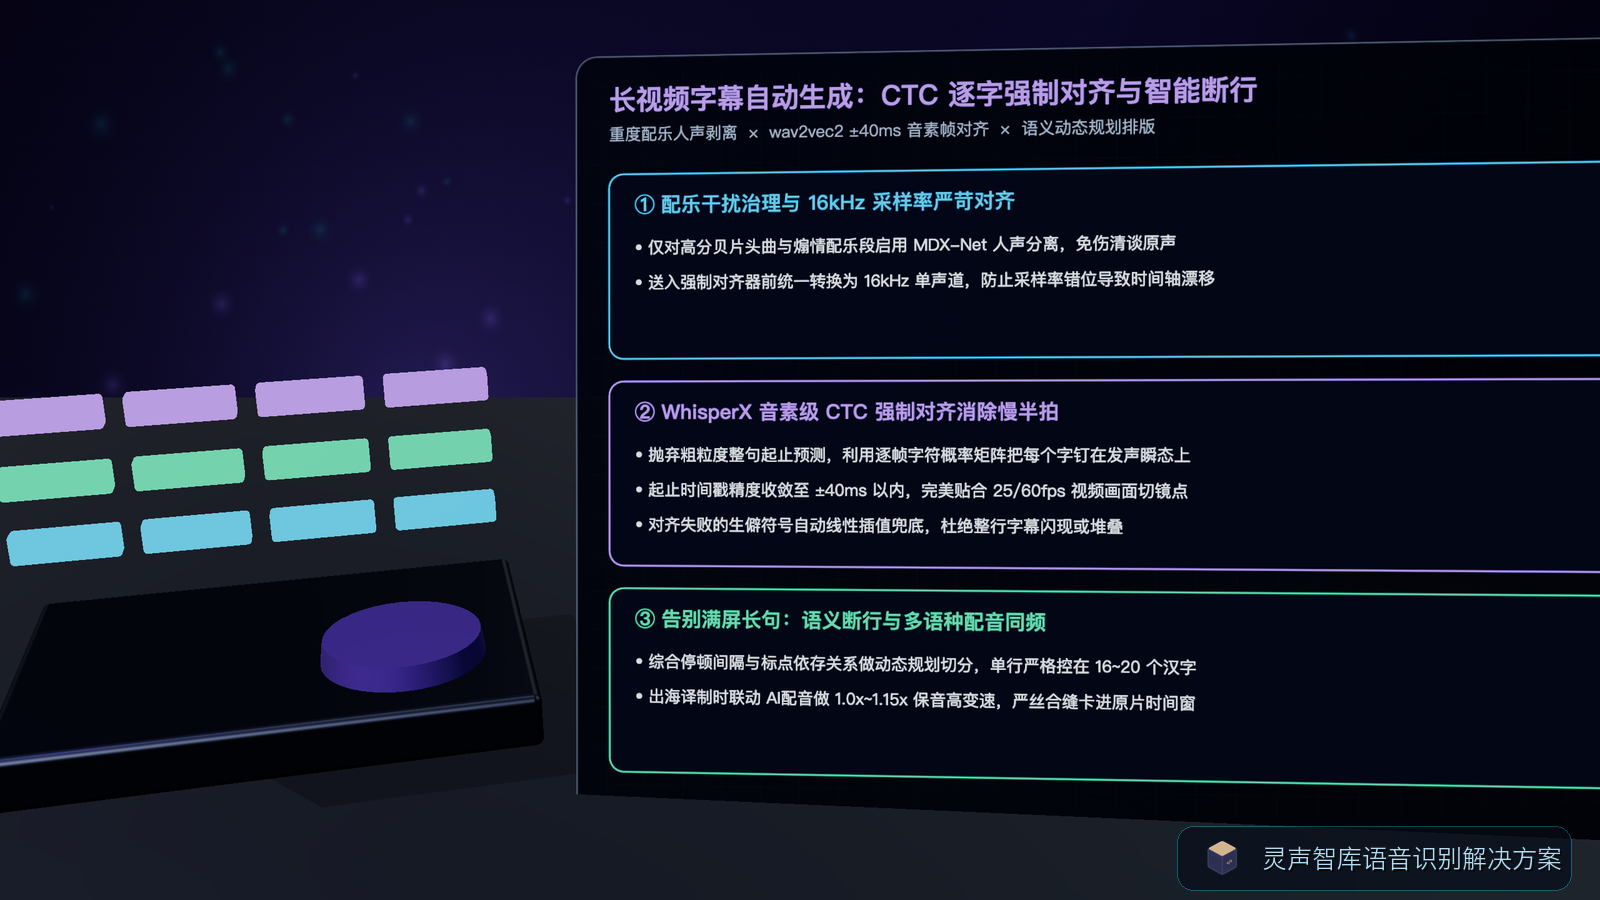
背景配乐按需剥离,别把清谈原声洗坏了
面对纪录片、综艺花字和带感人配乐的微短剧,高分贝伴奏乐器是拖垮字幕生成精度的另一大杀手:大提琴长音或架子鼓节奏极易把语音端点检测骗得团团转,把本来早已说完的句子尾巴硬往后拖出两三秒。对付这类素材,不能偷懒省掉音源分离,却也不能不分青红皂白把整部片子全丢进重型人声伴奏分离网络里洗一遍。
聪明的做法是先按频谱平坦度与谐波能量比快速扫描全片音轨:纯室内清谈、比如大型研讨会的会议语音转写录像,直接走原始干净音轨以保住高频齿音细节;只有检测到明显伴奏混叠的段落,才局部调用轻量 MDX-Net 模型剥离背景乐,用分离后的人声轨去算起止时间轴,有效规避了字幕跟着背景音乐“拖尾”的顽疾。倘若原片里还夹杂着观众鼓掌、哄堂大笑或者街头车流轰鸣,可以在分离后的人声轨上再叠加一道基于谱减与能量门限的双重端点过滤,把非言语噪音段彻底挡在时间轴框定范围之外,避免空白过渡镜头下莫名冒出一串乱码标点。
动态规划语义断行与镜头硬切点防闪烁吸附
拿到了精准到每个字的时间戳,怎样切分成观众看着舒服的字幕行同样是一门手艺。单纯按固定十八个字一刀切,经常把“人工智能”切成上一行末尾是“人工”、下一行开头是“智能”;单纯按停顿大于三百毫秒切,遇到语速飞快的辩论嘉宾又会攒出四十多个字的超长屏霸句。好用的排版器会把字间声学停顿时长、标点符号权重以及相邻词句法粘连度合在一起建一个代价函数,用动态规划寻找整段切分总代价极小的断点组合:优先在逗号、连词前或超过两百毫秒的自然换气处落刀,单行字数控制在十六到二十个汉字之间,单屏驻留时长不低于一秒、不超过五秒。遇到九比十六竖屏微短剧时,由于画面右侧和底部常驻点赞按钮与剧集标题栏,排版模板还要自动把单行上限收紧到十二个汉字以内,避开交互控件遮挡区。
专业影视成片还有一条老规矩叫“字幕不跨碎切点”:倘若某行字幕恰好在画面切镜头前两帧消失、或者在切镜后两帧才冒出来,观众视线会明显察觉到底部文字闪跳了一下。把视频关键帧直方图突变检测接入字幕后处理脚本,凡是字幕起止边界距离镜头切换帧不足一百二十毫秒的,自动把字幕入点或出点吸附对齐到切镜帧上,并校验相邻字幕块绝不发生毫秒级时间重叠,观感立刻向电视台精编成片看齐。
如果是做短剧出海多语种字幕生成联动 AI配音,英文或西语译文音节往往比中文原句长两成左右,直接塞进原字幕时间格会挤不下。参考灵声智库在多语种视听同频项目里的调优经验,先让译文精简口语化改写压缩一成字数,遇到双人对话交叠时导出区分字色与行位的 ASS 样式字幕,再对合成出的外语配音轨做一到一点一五倍的保音高时域微缩,就能稳稳对上演员原片口型起止点与字幕翻页节奏。
逐字对齐误差
±40ms
单行阅读字数
16~20字