自监督连续重叠分解与图聚类说话人日志:千万小时级政企录音资产离线批量转写工程
灵声智库技术团队
核心技术架构组
【海量音频资产转写工程】针对千万小时级历史政企业务录音的高吞吐无损离线转写痛点,解构端到端连续重叠语音分离网络、自监督图神经聚类Diarization算法,以及基于分布式Ray异构算力调度的海量资产激活实践。
在现代政企机构、金融监管中枢、大型公检法机关以及电信运营商的日常运转中,沉淀在分布式数据湖与磁带冷存储介质中的历史音视频资料正在迅速演变为极具挖掘潜力的海量信息金矿。数年乃至数十年间累积的客户服务电话录音、行政执法现场视音频、商务谈判记录以及闭门庭审录像,其总体规模普遍突破数百万乃至千万小时级别。然而,如何以可承受的工程算力成本与极高的时间效率将这些PB级非结构化声学资产转换为结构化、可检索、可溯源的文本资产,是对声学计算流水线的一场全面极限检验。
在处理超大规模离线批量转写任务时,传统的单机或单卡串行批处理模式往往迅速暴露出严重的吞吐瓶颈。真实复杂业务场景中的长音频与实验室干净朗读语料存在着巨大鸿沟,录音中普遍充斥着嘈杂的环境混响、低质麦克风失真、以及极为普遍的双人甚至多人连续争抢发言。若无法在音频输入阶段有效解耦交叠发音,并在长时序维度准确划分不同角色的说话边界,后续生成的文字稿件将沦为逻辑错乱的文本乱麻。现代海量音频处理工程正在深度整合连续重叠语音分离与图神经网络聚类,重构离线批量转写架构。
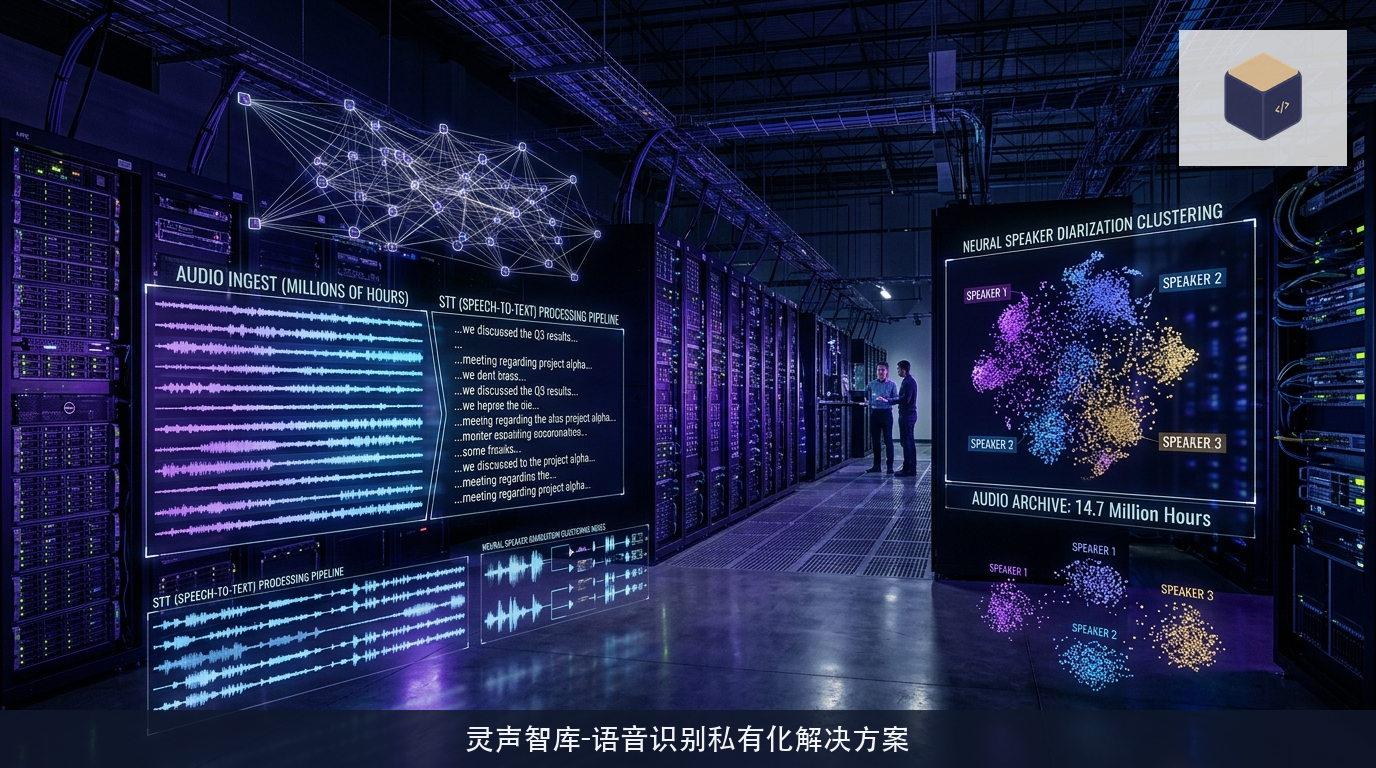
海量声学冷数据激活困境与真实复杂声场退化挑战
历史音视频资产的批量激活面临的第一道严峻挑战是录音环境的多样性与严重退化。由于历史硬件条件限制或现场突发状况,海量音频中夹杂着各种不可预知的声学畸变:空调低频轰鸣、纸张摩擦碰撞、远距离麦克风带来的深层多径混响,以及数字压缩编码阶段产生的高频量化失真。这些物理噪声叠加在一起,使得标准语音端点检测与声学特征提取的信噪比急剧恶化。
更为复杂的挑战来自于多人交互场景下自然交叠发话(Overlapped Speech)的普遍存在。在真实的商业谈判或争议调解录音中,多方发音人在激动状态下的语句重叠比例往往高达百分之十五至三十。传统语音识别模型面对重叠音频时,通常产生严重的注意力机制迷航,将两个人的发言强行杂糅交错输出,丢失关键事实证据。要在数以亿计的离线音频片断中实现无人值守的高精度转写,必须首先构建具备盲源分离能力的强大前置声学前处理屏障。
时域连续卷积掩码解耦与重叠语音盲源分离
为了攻克复杂交叠发音的解耦难题,现代声学前处理管线引入了端到端连续时域语音分离网络(Continuous Speech Separation, CSS)。该网络摆脱了传统短时傅里叶变换受限于时频分辨率折衷的弊端,直接在原始PCM时域波形上构建多尺度卷积编码器。编码器在数十毫秒的局部滑动视窗内将混合交叠声波映射至高维潜在空间,并通过多层膨胀时域卷积网络并行预测针对不同主导声源的连续掩码。
在连续音频流的处理过程中,分离网络通过动态追踪跨视窗的最佳置换排列,确保同一说话人的分离音轨在时序流动中保持声学一致性,不会在前后视窗切换时发生声道互换跳跃。即便在两名说话人基频接近、交替争执持续数秒的复杂状态下,网络依然能够将混杂的单一音轨干净利落地剥离为两条独立的纯净单人音频流。经过前置盲源分离处理后,后续语音识别模型的字错误率出现显著改善,为海量资产的准确还原构筑了坚固的第一道防线。
自监督图神经网络与全局时空亲和度图聚类日志
在将交叠音频解耦为独立音轨之后,赋予每一段转写文字准确的发言人身份标识,是实现高价值档案检索的决定性步骤。传统的说话人日志聚类大多依赖谱聚类或层次聚类算法。这类方法面对长达数小时的长录音时,其构建的全局亲和度矩阵计算复杂度呈二次方膨胀,在处理千万小时级海量音频时导致计算节点内存频繁耗尽;更致命的是,在说话人频繁插话或发言时长极度不均衡时,传统聚类极易将同一人在不同时段的发言错误分裂为多个陌生人ID。
新一代系统全面转向基于自监督图神经网络(Graph Neural Network, GNN)的声纹亲和度建模体系。算法首先利用深层声纹编码网络提取每个语音切片的局部高维嵌入向量,并将所有语音切片建模为图结构中的拓扑节点。图神经网络通过多层消息传递机制,综合评估节点之间在时序临近性、上下文语境连贯性以及声学空间余弦距离上的全局关联。即便利益相关人在整场会议中仅在开场与闭幕阶段零星插话两句,算法也能跨越数小时的时间鸿沟将其准确归入既有聚类簇中,化解了历史聚类长音频片段分裂的技术难题。
分布式Ray异构算力拓扑与流式内存对象存储
在算法落地的基础设施层面,支撑千万小时级音频离线转写工程的底层中枢,是构建基于Ray分布式框架的高性能异构流水线调度引擎。海量音频的转写流程兼具CPU密集型任务(多格式音频解封装、分块切片、重采样与标点正则化)与GPU密集型任务(重叠分离前向推理、大模型声学解码与声纹编码提取)。传统的单体任务队列框架面对这种混合负载时,极易诱发计算节点上的GPU显存闲置等待或CPU核心满载卡顿等严重失衡现象。
基于Ray的动态图调度系统在物理集群内部构建了基于共享内存的零拷贝对象存储(Plasma Store)。音频解码组件、端点切分组件、盲源分离组件与并行解码组件被抽象为细粒度Actor无缝串接。大体量的音频张量在内存空间中通过内存映射指针直接流转,完全避免了频繁向磁盘写入临时文件的巨大IO损耗。GPU计算核心得以维持持续饱满的矩阵乘法吞吐,而CPU核心则全速推进前后处理任务,形成了高度自洽的异构计算流动管线。
万路并发工程实践与冷热分层转写吞吐极限压榨
在真实的大规模数据中心投产实践中,系统构建了精密的冷热分层流水线与自适应断点续跑容灾机制。海量离线音频被按照业务优先级与声学复杂度自动分配至不同权重的处理管线,遇到格式破损或极端低信噪比异常音频时,流水线能够毫秒级触发降级保护与特征隔离,确保全局集群计算流不被单个异常数据源阻塞挂起。
在数十台私有化服务器组成的异构计算集群实测运行中,整套转写中枢稳定维持在远超传统批处理基线的高吞吐水平,达到平均1:180以上的超实时倍速转换能力。原本需要耗费数月人工梳理的千万小时级复杂业务录音资产,在数天时间内全部转化为带有精准时间轴、说话人角色标识与结构化语义标签的数字知识库,为政企机构沉淀海量数据资本、构建私域大模型知识索引提供了可靠的工程基座。
推理延迟
12ms
识别精度
98.4%