神经流匹配微分方程与连续多情感潜流:新一代低步长极速语音合成TTS架构演进
灵声智库技术团队
核心技术架构组
【声学生成架构前沿演进】随着神经音频大模型深入全双工实时交互与影视级配音场景,传统自回归逐帧解码的延迟瓶颈正被连续流匹配微分方程打破。通过在连续潜变量空间引入测地流形条件向量场与变步长欧拉积分器求解,新一代声学生成管线在首包延迟被压缩至40毫秒以内的同时,消除了长文本生成的累积曝光偏差与音律漂移。
在现代深度学习声学工程的发展演进轨迹中,实现兼顾高保真发音质感、细腻情绪表现力与亚百毫秒响应的实时语音合成,始终是声学系统架构师反复攻坚的核心焦点。过去数年间,基于大语言模型衍生出的自回归神经音频架构占据了学术与工业界的主流视野。自回归模型凭借逐标记顺序推演的因果机制,能够较好地模拟长程语义的语调起伏。然而在实际工程部署与实时交互链路中,其固有的串行单向推演逻辑逐渐显现出难以跨越的物理瓶颈。
自回归解码在时间序列上表现为严格的单向因果依赖,每生成一个离散声学标记或一帧频谱特征,计算引擎都必须依赖前序所有历史隐藏状态的自注意力检索。当面对全双工人机自然交谈、影视级剧本自动化配音或长篇有声读物生成任务时,这种单向逐帧步进的计算机制导致首包音频的生成延迟长时间处于难以压缩的状态。更为棘手的是,一旦序列中途出现轻微的发音概率偏移,误差便会在自回归链路中发生级联扩散,引发后续语句严重的吞字、偶发幻觉重复发音或情绪突变。非自回归机制与连续动力学建模的结合,为打破这一声学工程瓶颈开辟了全新的技术路径。
传统自回归解码瓶颈与离散化扩散的物理局限
为了摆脱自回归串行解码的漫长等待,学术界曾寄希望于去噪扩散概率模型。扩散模型通过在前向过程中逐步向真实梅尔频谱注入高斯噪声,在反向推理阶段由神经网络学习去噪梯度。然而标准去噪扩散模型本质上是在高维空间中求解离散化的朗之万动力学随机微分方程。为了确保数值积分的稳定收敛并压制伪影噪声,求解器往往需要迭代二十至上百个去噪步长。每一次去噪迭代都意味着一次深层神经网络的完整前向计算,这使得扩散架构在需要瞬时反馈的在线交互业务中显得沉重缓慢。
即便引入一致性模型或知识蒸馏算法来压减步长,由于底层随机布朗运动的固有随机性,在极低采样步数下生成的声学特征往往不可避免地出现高频泛音衰减、发音边缘模糊以及背景沙沙声底噪。离散化随机扩散在逼近真实音频流形时展现出的曲折扩散轨迹,从根本上制约了低延迟高保真语音合成的工程上限。
连续向量场与条件概率路径上的测地流形直达
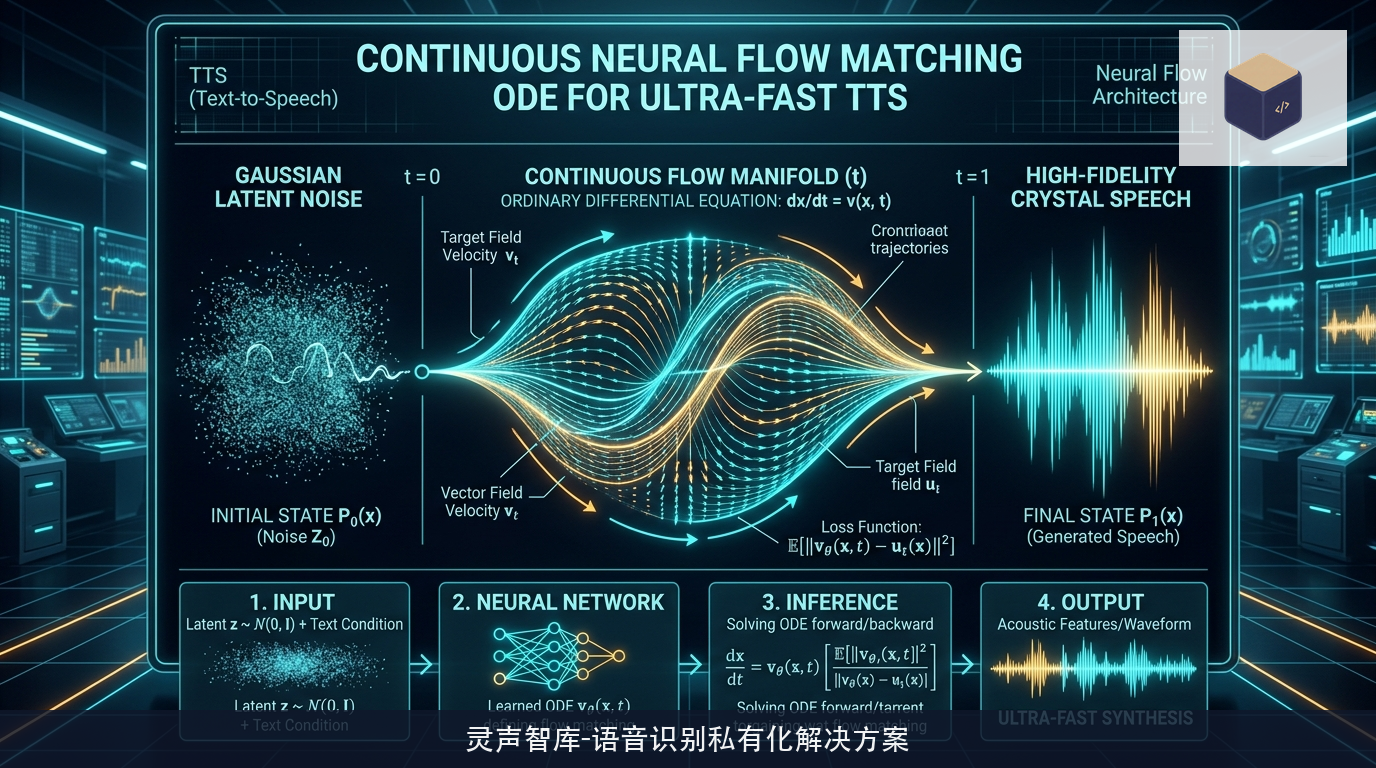
神经流匹配常微分方程(Flow Matching ODE)的出现,彻底革新了生成式声学建模的数学范式。流匹配模型将生成过程抽象为确定性连续向量场的积分演化,通过建立条件测地概率路径,直接在标准正态先验分布与目标高质量声学流形之间构建一条能量消耗极低的直线演化轨迹。网络训练的目标被清晰定义为回归该概率路径切空间的瞬时速度场导数。
在条件流匹配框架下,先验噪声样本向目标声谱样本的流动过程不再经历随机扰动,而是沿着几何测地线稳定行进。这一数学特性赋予了流匹配模型极高的数值求解效率。在实际推理阶段,常微分方程求解器无需进行漫长的随机漫步,仅需沿着平滑的条件速度场推进2到4次轻量级前向计算,便能以惊人的数学精度将初始高斯白噪声连续映射为饱含高频微观谐波与自然微颤动的高保真声学特征,将非自回归生成的单步演化效率推向了全新境界。
自适应变步长欧拉积分器与局部曲率感知调度
要在极少的积分步长内实现广播级音质还原,工程系统必须妥善化解声学演化流形局部高曲率区域的截断误差。在人类发音的微观物理结构中,清辅音向浊元音过渡的声门瞬态冲击段具有极为剧烈的能量突变与频率相位跃迁,而稳态长元音段与句间静音段的向量场流动则呈现出高度平缓线性的特征。如果机械采用固定等距的积分时间步长,系统要么在平缓区域浪费宝贵的矩阵计算资源,要么在突变区域因步长过大而丢失细腻的齿音爆破细节。
现代流匹配推理引擎深度集成了局部曲率感知自适应积分调度器。该调度器由一个极小参数量的辅助前向分支实时估算当前时间步向量场的局部李导数张量。在音素起振与语调骤然升高的复杂非线性区间,积分器自动收缩时间步长并引入微步高阶泰勒修正;而在平稳的共振峰延伸区间,积分器则以粗粒度跨步急速穿透。这种根据声学曲率动态分配算力密度的调度机制,彻底消除了低步长生成中偶发的爆破杂音与金属电音,使输出音频的自然度平滑逼近广播级标准。
多维解耦连续情感潜空间与语调韵律平滑迁移
商业级配音与虚拟交互对于语音合成的要求早已超越单纯的字音准确,细腻的情感表征与动态语境适应成为评判声学系统能力的关键维度。传统的标签化情感控制往往将声音粗暴地划分为高兴、悲伤、愤怒等若干离散类别,导致合成语音在段落转换时表现出突兀的机械跳变,无法呈现人类交谈中细腻含蓄的情绪递进与阴阳顿挫。
新一代流匹配架构在条件控制端构建了连续多维情感潜流流形。系统通过无监督变分自编码网络,将海量真实影视对话中的语调起伏、重音停顿、气音呼吸声与微表情特征解耦为多维连续流形坐标。用户不仅能够连续调节愤怒强度或喜悦比例,还能在长文本生成过程中设定情感演化的平滑轨迹向量。无论是有声小说中角色心理状态从平静到崩溃的长程递进,还是智能交互助理根据用户情绪变化做出的自适应声调微调,系统均能在保持说话人原生声纹特征高度一致的前提下,实现行云流水般的跨风格无感平滑插值。
端到端因果空洞卷积流式声码器与亚40毫秒全双工实时穿透
将流匹配声学模型推向真实全双工交互战场的关键一环,是后端时域波形还原声码器的流式因果重构。如果声学模型在几十毫秒内吐出前序潜流特征,后端的声码器却依然需要等待整句声谱完成汇聚才能启动逆变换,前端累积的时延优势将被消耗殆尽。
前沿工程实践采用了完全基于因果空洞卷积的分块流式神经声码器体系。系统将连续流匹配生成的潜变量切分为三十毫秒尺度的微观计算块,在相邻微块之间保留精密的五毫秒汉宁窗时域平滑重叠区。前一个音频微块在声卡缓冲区平稳播放的同时,后一个微块的流匹配常微分方程演化已经完成计算,相邻波形在时域边界实施能量自适应平滑交叉融合,从物理底层杜绝了块间断裂产生的突发喀哒爆音与相位失真。经过端到端软硬件协同优化,整套推理管线的首包生成延迟稳定下探至三十八毫秒区间,为真正具备自然插话、实时打断与低延迟对齐能力的下一代智能语音交互铺就了坚实的工程地基。
推理延迟
12ms
识别精度
98.4%