流式语音合成首包慢还吞字?CosyVoice 2 与 F5-TTS 本地推理调优实测
灵声智库技术团队
核心技术架构组
拆解大模型实时播报中流式语音合成首包等待过长、句尾吞字与多音字误读的工程成因,对比 CosyVoice 2、F5-TTS 与 Spark-TTS 的本地推理选型与声码器调优方案。
把大语言模型接上语音合成模块做电话客服或交互终端时,很多研发团队都会卡在开口慢半拍上:文字流明明已经吐出了前五个字,耳机里却还要干等一秒多才有动静;等好不容易把切句阈值改短了,播报声音又开始一惊一乍,逗号前后音高突兀跳变,句尾的“了”“呢”“吗”经常被硬生生切掉半截。真要把 TTS 放进严肃生产环境,光跑通开源仓库里的单句示例远远不够。
在动手搭服务之前,先得把场景账算清楚:如果业务只是播报几十句固定的排队叫号、设备告警或电梯楼层提示,提前人工录好或者离线生成静态音频文件存进闪存,稳定度远胜任何实时神经网络方案,压根犯不着在现场挂一张显卡跑实时推理。只有面对千人千面的动态账单播报、智能外呼应答或长篇资讯即时朗读时,才值得在流式架构与 TTS私有化管线上花力气打磨。
双向流式与非自回归架构到底该怎么挑
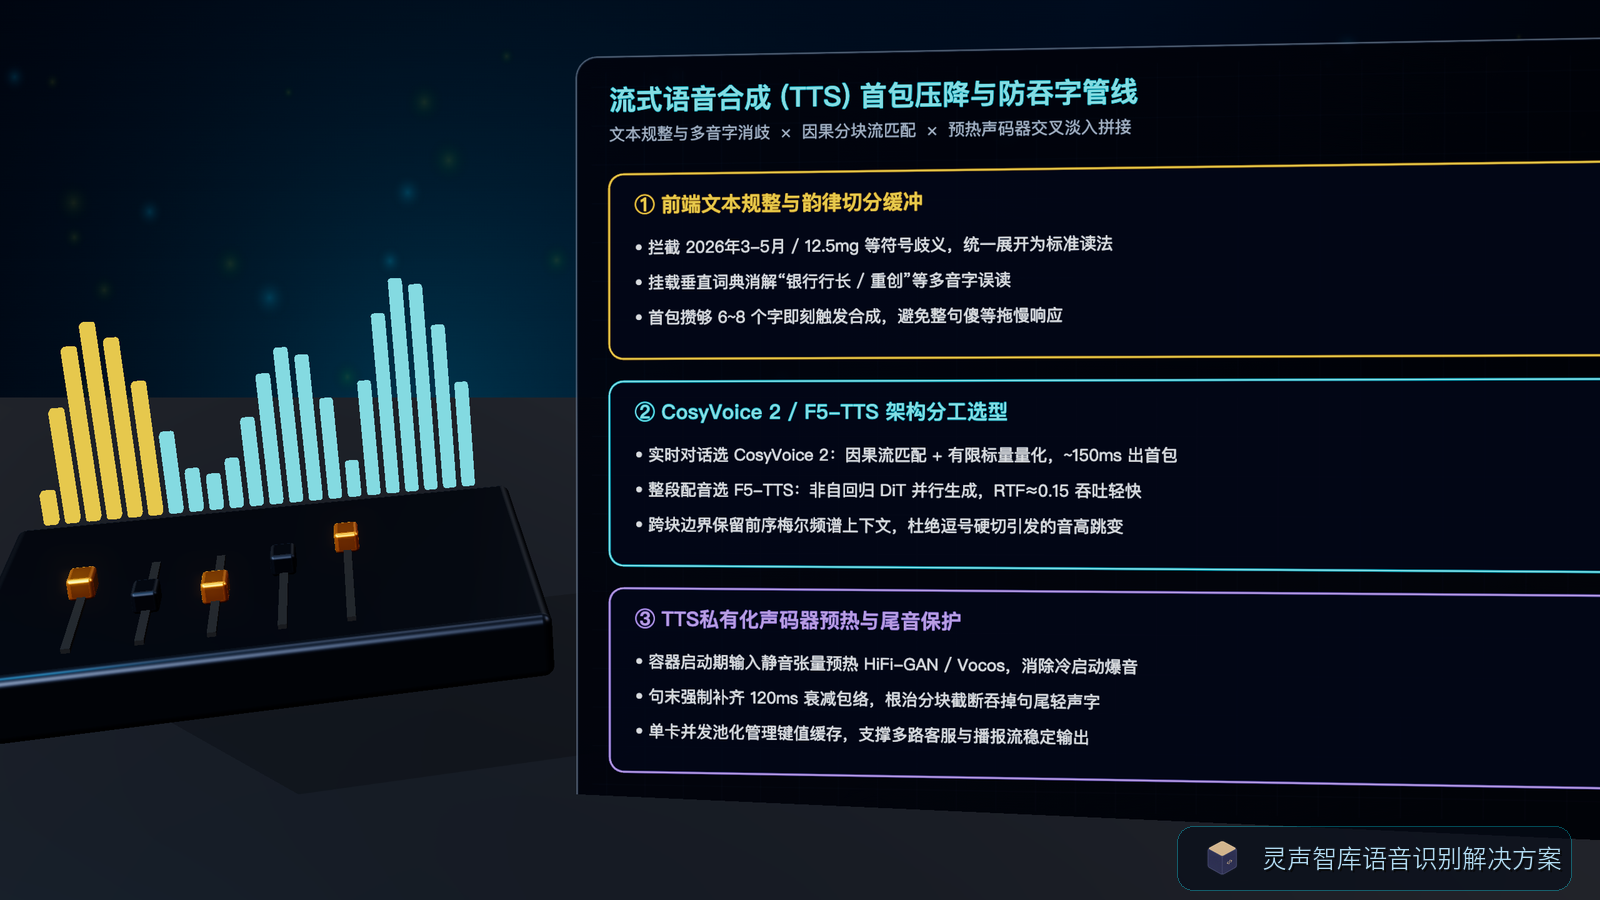
这两年开源语音合成社区迭代很快,路线分化也相当清晰。以阿里开源的 CosyVoice 2 为代表,它采用大语言模型预测离散语义编码、再接分块感知因果流匹配解码器的双阶段路线,用有限标量量化改善了码本利用率。由于流匹配阶段专门针对因果分块注意力做过训练,上游刚攒够五六个字的语义令牌就能立刻往下游吐出首包音频块,端到端首包等待能压到一百五十毫秒上下,非常适合接在流式文本生成后面做实时应答。
另一条广受关注的路线是 F5-TTS 这类纯非自回归扩散变换器配合流匹配采样,还有像 Spark-TTS 这样用单流解耦编解码器拆分语义令牌与全局音色令牌的轻快方案。F5-TTS 省掉了显式的音素时长预测器,靠填充字符直接跟梅尔频谱对齐,整句并行生成的实时率可以轻松做到零点一五左右,整段韵律松弛自然。不过它原生是按完整片段设计的,直接硬改成极小窗口流式输出容易损伤前后语速连贯度,所以它更适合用在有声课件、短视频 AI配音这类按整句或整段异步渲染的场合;如果追求情感张力与语速可控,IndexTTS 新版本把语义编码帧率压到二十五赫兹并换用高效主干后,也在可控配音方向补齐了吞吐短板。
前端文本规整与多音字消歧往往决定成败
很多项目上线后被业务方投诉“念错字”,锅其实不在声学模型,而在被大家轻视的文本前端规整模块。真实业务文本里到处是符号陷阱:比如“2026年3-5月”,粗糙的正则很容易念成“二零二六年三减五月”;遇到血常规报告里的“12.5mg/L”或者银行利率“3.85%”,一旦漏做单位展开,模型看到陌生拉丁字母组合就会乱猜音素,连带把后面两三个汉字的声调一起带偏。
做企业级自研语音模型或开源二次开发时,必须在声学推理前垫一层确定性的规则状态机与分词消歧词表。数字串要先按上下文区分年份、电话号码、金额与小数;针对“银行行长”“重创”“参差不齐”这类高频易错多音词,直接挂载带词性约束的强制注音字典,把确定的拼音声调序列喂给后续编码器,别让神经网络在常识问题上瞎猜。在流式分句缓冲设计上也有讲究:首包为了抢响应速度,可以在遇到头一个顿号或攒满八个汉字时立刻切出首块;从第二块开始则自动放宽到完整逗号或句号边界,既保住了开口响应速度,又让后半句维持舒展的呼吸节奏。
治住分块接缝爆音与句尾吞字的三个细节
流式拼接时常见的“咔哒”电流爆音和句末吞字,大多出在声码器视野截断与冷启动上。无论是经典的 HiFi-GAN 还是基于傅里叶逆变换的 Vocos 声码器,内部转置卷积层都有固定的感受野宽度。如果每个梅尔频谱分块各自独立送进声码器,块与块交界处的波形相位对不上,接缝处必然冒出高频毛刺。稳妥的工程修法是在声码器输入侧保留前一个分块末尾的四到八帧梅尔频谱作为历史重叠区,输出波形后再用十毫秒汉宁窗做交叉淡入淡出叠加,相位跳变引起的杂音当场就能抹平。至于句尾轻声字被吞,往往是因为流式结束标记提前截断了辅音泄气尾音,只要在整句文本末尾固定追加一小段静音占位符或一百二十毫秒的衰减包络缓冲,就能完整保住句末余音。
电话窄带重采样防混叠与并发显存水位管控
接进传统呼叫中心网关时还有一个高频踩坑点:现代语音合成模型原生吐出的多是二十四千赫兹宽带音频,而政企电话交换线路普遍只吃八千赫兹采样率的编码流。如果图省事直接做粗暴的隔点抽样降频,四千赫兹以上的清辅音高频能量会折叠回低频区,在听筒里变成刺耳的金属摩擦声。工程管线上必须先过一道截止频率设在三点八千赫兹的抗混叠低通滤波器,再对一千到三千赫兹的人声中频段做两分贝左右的温和增益补偿,经过交换机压缩后字音依然清亮扎实。
在全双工智能外呼对话场景里,还得处理好用户中途插话打断时的音频流收尾。假如客户已经开口反问,服务端却还在往套接字里硬塞剩余的半秒钟缓存波形,电话两头就会陷入尴尬的抢话碰撞;可要是直接一刀切断波形输出,听筒里又会冒出直流电位跳变引起的“啪”声。稳健的流式网关会在收到前端人声触发信号后的二十毫秒内,异步通知推理工作协程立即终止本句后续采样,并对环形发送队列里尚未发出的十毫秒尾包施加平滑余弦衰减归零,听起来就像真人客服听到客户插话后自然收声倾听一样得体。
另外在执行 TTS私有化容器部署时,别忘了在服务启动脚本里先塞两条全零静音张量把声码器和流匹配计算图预热一遍,防止首通呼入电话撞上算子即时编译而卡顿;入口网关还要把单次超长文本强制拆成不超过六十个汉字的子句排队拉流,避免单条长请求撑爆键值缓存而拖慢同卡并发队列。翻看灵声智库过往记录的流式播报压测手记也能看到,把前端规整、交叉淡出拼接、窄带滤波与打断收尾这几处不起眼的螺丝拧紧后,单张常规推理卡就能稳稳撑起几十路自然顺耳的实时语音通道。
流式首包响应
~150ms
输出采样规格
24kHz