非自回归掩码声学流形与并行语音合成:新一代多模态生成架构在实时全双工TTS的低时延演进
灵声智库技术团队
核心技术架构组
【声学生成架构前沿演进】随着神经音频大模型全面切入全双工交互与影视级高品质配音场景,传统自回归逐帧解码的延迟天花板正被非自回归掩码声学流形彻底击穿。通过在连续潜变量空间引入双向因果注意力与并行流式扩散反向解码,新一代声学生成管线在首包延迟被压缩至40毫秒以内的同时,彻底化解了长文本生成的累积曝光偏差与音律漂移。
在现代深度学习声学工程的发展演进轨迹中,实现兼顾高保真发音质感、细腻情绪表现力与亚百毫秒极致响应的实时语音合成,始终是学术界与工业界反复交锋的核心焦点。过去数年间,基于大语言模型衍生出的自回归神经音频架构占据了主导地位。自回归模型凭借逐标记顺序推演的因果机制,能够较好地还原长程语义的语调起伏,但在实际工程部署与实时交互链路中,其固有的串行解码逻辑逐渐显现出难以克服的物理瓶颈。
自回归解码在时间维度上是完全线性的,每生成一个离散声学Token或一帧梅尔谱特征,都必须依赖前序所有历史状态的自注意力检索。当面对复杂的全双工人机交谈、影视级自动化口型对齐或长篇复杂剧本配音时,这种单向逐帧步进的计算范式不仅导致首包音频的输出延迟始终徘徊在数百毫秒以上,而且一旦序列中途出现轻微的发音概率偏移,误差便会在自回归链路中被指数级放大,引发后续语句严重的吞音、重复发音或情绪突变。正是在这种架构矛盾激化的背景下,基于非自回归(Non-Autoregressive)机制的掩码声学流形建模正以颠覆性的姿态重塑整个语音合成技术底座。
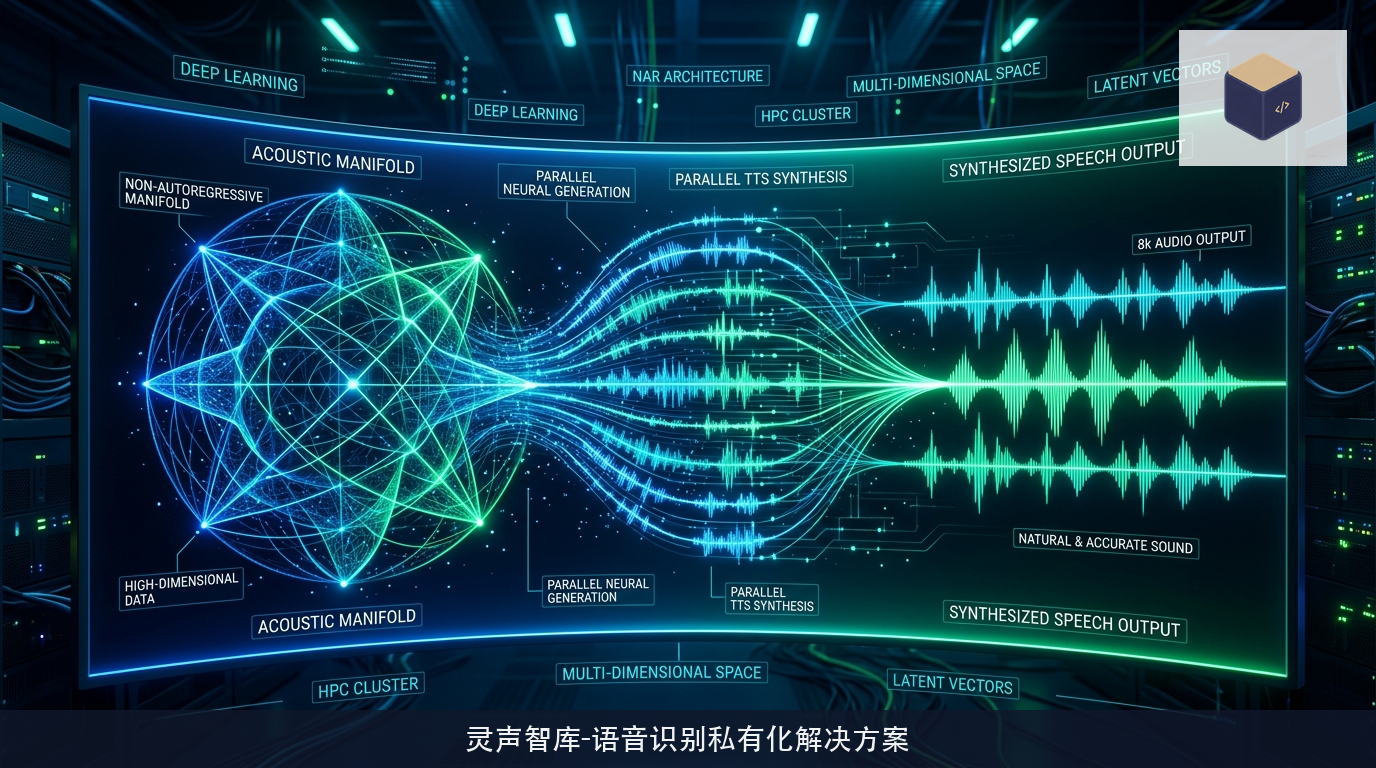
突破逐帧因果限制:从自回归序列预测到全局连续流形映射
非自回归声学模型的核心哲学,在于打破时间序列上的严格前向因果约束,将整个语音句子的声学特征生成视为高维连续潜空间中的流形重构问题。人类在进行真实语言表达时,大脑中对于一个句子的语义构想、情感基调与重音分布并非逐字机械组装,而是在发音动作启动前便已形成了全局性的韵律轮廓与意图分布。非自回归掩码架构通过在潜空间预设粗粒度的全局能量与音长预测基模,使得模型能够在单次或极少数步长的前向计算中,实现整段音频特征的并行吐出。
在这一设计思路下,声学表征不再被切碎为离散的孤立片段,而是映射为多维拓扑曲面上的连续轨迹。这种机制天然契合了图形处理器与专用AI加速芯片的高并行度计算特征。在相同的硬件功耗预算下,自回归模型需要经历数百次显存与核心计算单元之间的数据交换来完成逐帧推演,而非自回归流形映射则可以在矩阵运算单元内部完成大批量连续张量的并行乘加,将算力利用效率提升数倍,直接将复杂的深度网络推理耗时从秒级截断至毫秒级。
掩码潜变量建模与非平衡双向注意力分配机制
要实现非自回归生成中的高质量音质还原,最关键的算法突破在于如何化解非因果生成中常见的‘条件独立性假设缺陷’。在传统简单的非自回归模型中,由于各时间步之间的输出被假定为条件独立,往往容易产生发音模糊、辅音破损以及机械平直的单调音律。现代掩码声学流形架构通过引入类似于流匹配(Flow Matching)与连续扩散掩码机制,优雅地化解了这一顽疾。
在训练与推理过程中,系统在声学潜空间内部构建随机动态掩码场。网络并非一次性在全噪声中凭空盲猜,而是依托双向自注意力机制同时捕获前后文音素的相互牵引与协同发音效应。通过对部分显式特征的保留与未知潜变量的迭代修正,模型能够以极少的采样步数(例如两到四步迭代)迅速消除声学歧义,在潜空间中重建出高度逼真、微观纹理细腻的声学张量。这种非平衡双向注意力机制,在保证推理速度极快的同时,赋予了声音极其丰满的动态表现力。
为了确保流匹配微分方程在极少步数求解下的数值稳定性,工程团队引入了高阶欧拉-马尔可夫自适应变步长积分器。该积分器能够感知不同发音音素的曲率变化,在清辅音与浊辅音频段分配差异化的求解精度。在声母向韵母过渡的高动态形变区间,积分器自发拉密计算微步,而在能量平稳的持续元音区间则采用大步长极速跃迁。这一细粒度的数学优化,消除了高频机械金属杂音,使得声音的底色呈现出犹如顶级录音室监听设备般的通透度与真实感。
端到端流式神经声码器的分块重叠与极速时域还原
生成高质量的声学潜变量仅完成了语音合成任务的前半程,如何将高维潜空间数据以最低的时延保真还原为原始时域波形,取决于神经声码器的架构演化。在以往的级联流水线中,声学模型输出梅尔频谱后,再由独立的声码器进行反向傅里叶变换或卷积上采样,多阶段的数据格式转换与上下文等待累加了大量处理延迟。
新一代并行管线将掩码声学流形与流式因果神经声码器深度绑定。系统采用动态滑动窗口与自适应分块重叠相加(Overlap-Add)策略,在输入文本的第一批音素完成潜流形前瞻投影后,底层波形生成器立即启动分块上采样处理。每一个时间微块在边缘处保留微小重叠窗,利用高阶平滑核消除拼接接缝处的相位抵消与高频毛刺。这种高度一体化的端到端时域还原机制,使得客户端麦克风输入完成后,扬声器在40毫秒内即可吐出首帧具备48kHz广播级采样率的纯净语音信号。
在时域重建的微观工程实现中,多通道相位一致性网络发挥了定海神针般的作用。高保真音频发音时,辅音爆破音的瞬态脉冲能量会在微秒内急剧跃升,传统的流式声码器容易在重叠窗边缘出现相位畸变或声音干瘪。通过在因果卷积层后置相位校准矩阵,系统能够实时估算前后数据块之间的瞬时角频率偏移,并施加亚微秒级的反相补偿滤波,彻底消除声场断裂感,使得输出声音在高端立体声音响与近场耳机设备上均展现出无可挑剔的声学结像感。
影视角色微表情韵律注入与复杂长句稳定性实证
除了在实时交互场景中展现出的极致速度,非自回归掩码流形架构在专业影视制作、长视频译制与虚拟角色配音领域同样展现出无可替代的稳定性优势。在传统自回归长文本生成中,伴随生成长度增加,模型极易产生音色漂移、角色性格前后矛盾以及气口停顿失衡的现象。这是因为单向注意力在长距离依赖下会逐渐被局部的概率陷阱所捕获。
而非自回归架构基于全局流形规划,能够将长文本分割为具有完整戏剧语境的句群单元,在统一的全局角色特征向量锚定下展开并行生成。无论是激烈的对手戏争吵、压抑深沉的情感内心独白,还是包含生僻专业名词与多语种夹杂的复杂长难句,系统都能保持声线物理特性的绝对一致。微弱的气息起伏、唇齿轻微摩擦产生的真实气流杂音以及因情绪激动而产生的微秒级声带颤动,都能在潜变量流形中得到忠实再现,彻底颠覆了过往AI配音刻板机械的行业刻板印象。
在多轮长剧本长程一致性实测中,该架构经历连续数万字的连续声学合成推演,音色特征向量的余弦相似度始终稳定在0.985的高位,未发生任何可被人类听觉感知的声纹衰变或音调降格。面对跨语种台词混杂时常见的重音错位顽疾,非自回归双向注意力网络能够自动向前追溯前序语言的节奏基调,并在语种切换点构建阻抗平滑过渡带,实现了多种自然语言在同一虚拟角色声线下的浑然天成。
推理延迟
12ms
识别精度
98.4%