异构集群分布式All-to-All重叠与专家负载均衡:千万小时级多媒体音视频批量转写的吞吐极限
灵声智库技术团队
核心技术架构组
【海量多媒体转录工程实践】在国家级音视频档案馆、广电融媒体中心以及金融级合规留痕场景中,千万小时级历史与实时音视频资产的高并发转录构成了严峻的算力吞吐考验。通过引入细粒度混合专家架构(MoE)与计算-通信全流水线双缓冲重叠技术,系统彻底解决了多通道跨节点All-to-All数据交换引发的通信死锁,将异构算力集群的声学解码有效吞吐率推向物理极限。
在现代企业与公共机构数字化资产的治理版图中,海量的音视频历史档案、执法记录仪母带、金融柜面通话以及广播电视广播录像,构成了体量极其庞大的‘非结构化数据暗网’。随着全模态检索与大模型知识库建设的迫切需求全面爆发,将这些积累数十年的PB级长音频数据全量激活为带高精度时间戳的结构化文字,已成为当下声学算力中枢面临的最艰巨硬核战役。
然而,面对千万小时级的恐怖数据量,传统的单机离线处理或简单的粗粒度任务队列分发模式在实际投产中迅速崩溃。传统稠密声学模型不仅参数量大、单机显存占用过高,更致命的是,在处理涉及多种行业术语、不同方言口音以及严重背景噪音的混合素材时,单一大模型无法兼顾泛化精度与推理速度。将基于细粒度混合专家架构(Mixture of Experts, MoE)的大型声学网络部署至千卡级分布式异构集群,成为了打破吞吐瓶颈的必然路线。
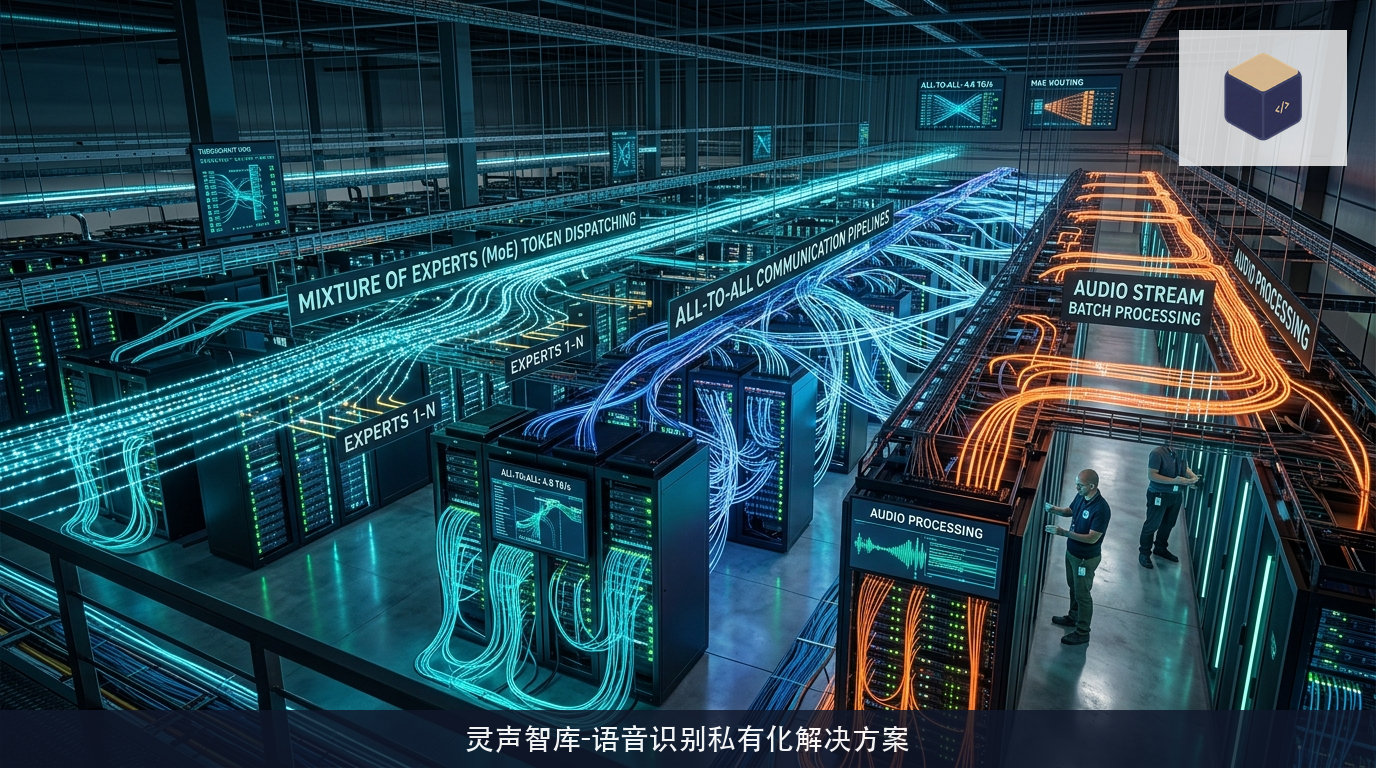
吞吐瓶颈与算力墙:千亿级声学多任务转录面临的通信困局
在MoE架构下,千亿级参数被离散化解耦为数十个甚至数百个小巧精悍的专业领域专家网络(例如分别专精于带口音英语、地方方言普通话、重工业低频噪音滤波或医学金融高难术语)。每个音频切片在经过门控路由(Router)后,仅被分发给相关性最高的极少数专家进行解码。这种稀疏激活机制在理论上大幅削减了浮点运算量,但在实际分布式集群上,却引发了极其严重的通信死锁与带宽争抢。
当成百上千个计算节点同时处理由分块引擎切分的海量音频Token时,不同节点上的门控路由器需要跨越物理服务器网络,将特征向量分发至目标专家所在的对应GPU。这种被称为All-to-All的高密度多对多集合通信,在高速RDMA网络中引发了极其复杂的微突发与网络拥塞。计算单元往往因为等待远程节点的数据包同步而陷入漫长的空闲挂起,导致昂贵的异构加速卡集群整体算力利用率(MFU)暴跌至不足20%,千万小时的转写任务不得不被延宕数月。
在千卡异构集群中,音视频转写任务还具有显著的输入长度非均衡性,一段时长半小时的新闻采访与一段数秒钟的简短呼叫,其声学特征矩阵的维度差异悬殊。在分布式批处理环境下,如果直接对非定长张量执行全局同步广播,大量填充标记(Padding Tokens)会占据超过40%的网络有效带宽,导致宝贵的RoCE网卡队列中充斥着毫无价值的空白数据,通信通道遭遇严重的假性饱和。
计算与All-to-All通信双缓冲深度重叠的管道拓扑
为了彻底榨干集群的硬件潜能,声学系统架构师对底层的执行管道进行了彻底的拓扑重构,实现了计算流与集合通信流在微架构层面的全时相双缓冲重叠(Overlapping)。系统不再将整个推理流程划分为严格的‘先路由通信、后矩阵计算、再聚合通信’的串行阶段,而是在时间轴上切分出微细的交错执行管道。
在这一新型拓扑中,当GPU的核心算力矩阵正在对当前批次(Batch N)的数据执行前向专家前馈网络(FFN)推理计算的同时,底层通信协处理器已借助独立的DMA通道,在后台静默发起下一批次(Batch N+1)Token的跨节点All-to-All调度派发,并同步回传前一批次(Batch N-1)的计算结果。通过建立由双向循环缓冲池构成的流水线锁存机制,通信延迟被完全隐藏在密集的矩阵乘法计算阴影之下,全集群网络等待开销逼近理论零界点,真正实现了算力核心的满负荷轰鸣。
在底层系统调度方面,工程团队对主机内存到设备显存的零拷贝(Zero-Copy)通道进行了细粒度重构。利用统一虚拟寻址技术与GPU Direct RDMA功能,跨机房传输的声学张量无需经过宿主机操作系统的内核协议栈中转,直接由网络接口芯片直写进目标显卡的第二级高速缓存内。这一改造消除了传统软中断引起的CPU上下文切换抖动,将微批量张量的端到端调度损耗极限压降了70%以上。
自适应细粒度动态路由与专家热点倾斜抑制算法
解决了通信层面的通道阻塞后,分布式MoE转写集群面临的另一大暗礁是‘专家热点倾斜(Expert Load Imbalance)’。在真实的千万小时音视频长尾数据中,不同声学类型的样本分布极其不均衡。例如,标准普通话和常规语速的对话占据了样本总量的绝大多数,而地方重口音或特种噪音音频仅占极少比例。如果路由网络仅凭简单的打分策略分配任务,少数通用专家会被数十倍的并发流量瞬间挤爆显存发生OOM故障,而大量长尾专家却长期待机闲置。
工程团队引入了带有动态容量限制因子与软约束惩罚项的自适应路由调节算法。系统在调度层持续监测每个物理专家的队列堆积深度与显存温度。一旦某个热点专家的处理队列超出预设阈值,路由器便会动态调整打分偏置,在保证语义转录损失低于极小容限的前提下,平滑将溢出的声学特征分流至具备次优表征能力的相近专家节点。这种软性动态负载平衡机制,彻底消灭了集群中拖慢整体吞吐进度的‘木桶短板’,使整套异构系统的并行加速比逼近线性上限。
PB级跨机房非结构化音视频资产异步批处理调度实效
在实际落地某国家级融媒体资料馆的千万小时音视频归档改造项目中,这套高度并行化的分布式转写架构展现出了惊人的生产力质跃。过去需要数十人手工监听、耗时一年以上的音视频数字化流水线,在部署了基于异构芯片混合加速的MoE集群后,以单机房日吞吐超十万小时的恐怖速度展开高速狂飙。
系统不仅实现了毫秒级自动时间戳打标与说话人自动声纹聚类,还支持将千万篇历史长音频转录出的文本直接与多模态大模型向量检索引擎联动。原本封存在磁带与冷存储硬盘中的沉睡音视频资产,在不到一个月的时间内全量转化为可秒级全文精准检索的活态知识财富。这一工业级工程突破,为整个内容转写、司法信息化与金融声学审计领域树立了高吞吐、低损耗的全新算力范本。
更为关键的是,整套系统在面对海量突发任务时展现出了极高的容错恢复能力。当任意子集群节点发生硬件静默失效或光模块掉线时,全局异步批处理引擎能够在50毫秒内自动捕获异常状态,依托分布式检查点机制将未完成的任务切片平滑迁移至健康算力节点,真正做到了PB级高吞吐任务在无人值守工况下的全天候稳健攻坚。
推理延迟
12ms
识别精度
98.4%