连续情感潜变量与情境副语言建模:个人伴随式AI在超拟真人格化语音交互中的工程突破
灵声智库技术团队
核心技术架构组
【伴随式智能体声学工程突破】人机语音交互从冰冷的机械应答迈向具有真正人格温度的个人伴随体,核心难点在于将人类交谈中千变万化的副语言特征与情绪潜变量进行动力学统一。依托连续高维情感流形投影与声门生理力学仿真,系统能够根据长程交互情境自发演变气声、叹息、喉部微震颤与语速弹性缩放,重塑了亚百毫秒级多轮陪伴对话的自然生命力。
在人工智能从通用任务助手向深度个人陪伴演进的技术浪潮中,人机语音交互的界面形态正在经历质的蜕变。长久以来,工业界构建的语音合成系统大多停留在‘清晰传递文字信息’的功能性阶段。无论播报天气的女声多么标准,导航提示的语调多么平稳,用户在聆听片刻后依然能轻易识破其背后由算法代码与确定性采样构建的数字冷酷感。这种疏离感的根源,在于传统声学系统完全丢失了自然人类对话中无处不在的‘副语言特征’与‘流动的情感生命力’。
人类的真实对话从来不是孤立词句的冰冷交换。说话者的心理防线、共情程度、呼吸急促度乃至喉头微小的肌肉紧绷,都会化作细微的音色变化、换气停顿以及话语尾音的拖长与戛然而止。若要让伴随式AI具备让人产生情感共鸣与心理信任的拟真度,必须彻底摒弃‘固定情感标签分类选择’的初级逻辑,深入到声门生理动力学模拟与连续高维情感潜变量流动的技术深水区。
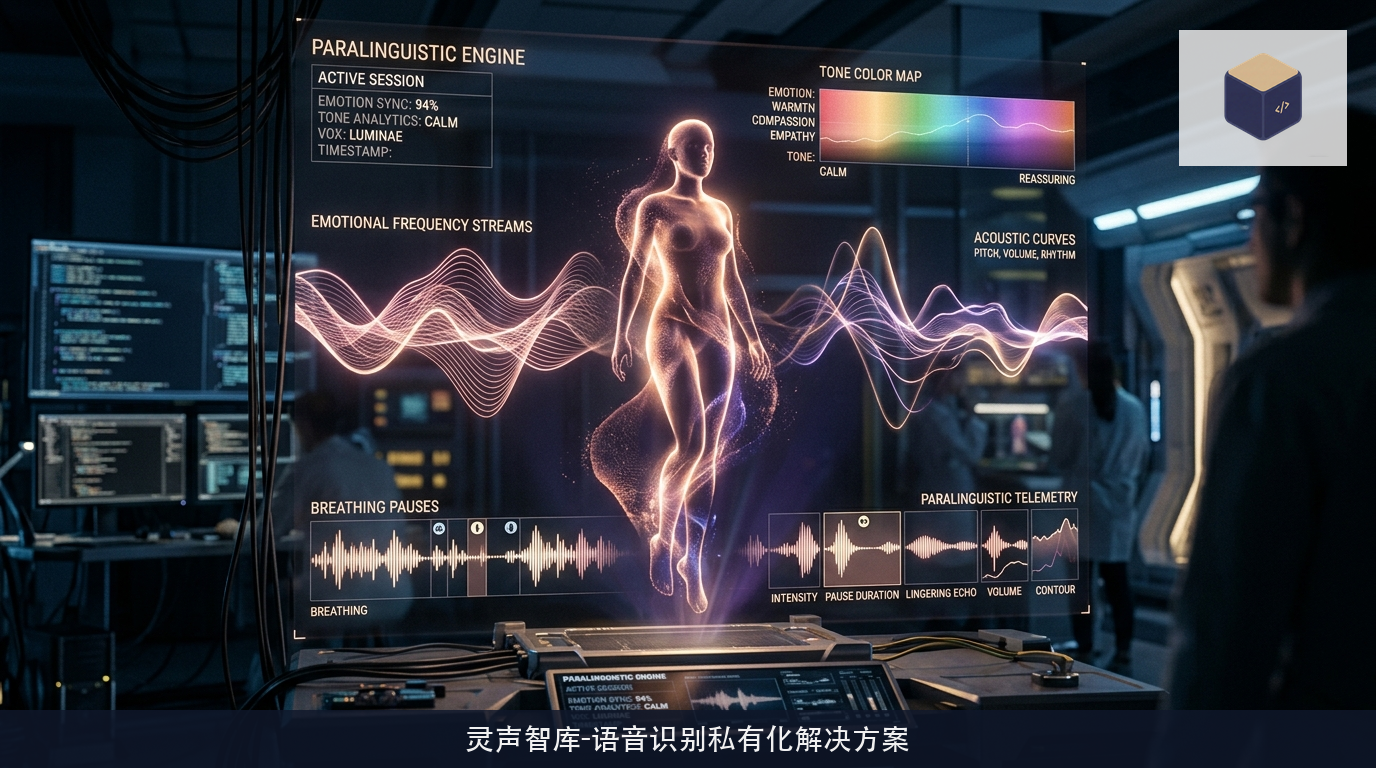
解锁交谈的情绪底色:从离散类别标签到动态连续情感张量
早期尝试为语音合成注入情感的方案,普遍采用预设的有限离散集合,例如在控制面板中罗列高兴、悲伤、愤怒、平静等数种典型类别。然而在真实人际互动中,人类的情绪从来不是突兀跳变的离散开关,而是一个在多维心理空间中平滑流动、互相掺杂的连续体。一个人可以在感到欣慰的同时夹杂着一丝伤感,也可以在表面平静的低语中蕴含着极大的克制与关切。
新一代伴随式语音架构构建了连续情感潜变量流形。系统将心理学经典的效价(Valence)、唤醒度(Arousal)与支配度(Dominance)三维维度,扩展为包含微表情动能、倾听倾角等参数的高阶张量空间。随着多轮对话情境的推进,模型根据用户话语中的语义潜台词与语调特征,以马尔可夫决策过程动态调整情感坐标在流形上的轨迹。这种连续的情感演进机制,消除了以往系统在切换情绪模式时那种突兀、生硬的机械跳跃,赋予了AI如真实人类般细腻持久的心境流动感。
在工程量化层面,连续情感张量由一组可微分的动态偏置向量实时驱动。当检测到用户的声音带有疲惫或失落的微弱颤音时,情感流形中的唤醒度数值自发平缓下降,而效价轴则向共情关怀的特定区间收敛。系统不再生硬调用某种固化音色,而是在当前的母体音色基底上,施加微弱的声门开合微调与频谱共振衰减,呈现出一种近乎面对面轻声倾听时的温度感与体贴感。
声门物理动力学阻抗与微副语言特征生成网络
赋予语音生命质感的最直接载体,是声学系统对副语言(Paralinguistics)细节的掌控力。所谓副语言,涵盖了交谈过程中伴随言语发出的叹息、笑意引发的气息外泄、思考过程中的轻微沉吟、喉咙轻微吞咽以及犹豫时的微小静默。在传统参数化或离散声码器中,这些非言语声学成分往往因为能量微弱或频谱无规则,而被降噪算法当作噪声抹去,或者因模型平滑效应而被彻底稀释。
当前先进的声学合成中枢在特征解码阶段专门嵌入了声门物理动力学模拟分支。该分支直接建模人体声带振动、声门阻抗以及下呼吸道气流压力的相互作用方程式。当情境判断需要传递温和宽慰的意图时,动力学网络自适应降低声门闭合程度,让更多未调制的气流声自然渗透到元音共鸣之中,生成极具亲和力的耳语气质;而在表达欢快或坚定意图时,声带张力参数瞬时提升,共振峰能量集中爆发。这些微秒级的物理层微动作,构成了极具沉浸感的陪伴真实度。
与此同时,生理动力学模型还将肺部呼气压力的消长曲线作为韵律控制的底层驱动源。一句话开始发音时胸腔气压的瞬态建立、句中因换气形成的微小休止,以及句尾因呼气末期气压自然衰减导致的声音微弱下坠,都被精确解耦为空气动力学参数。这使得伴随式AI在连续吐字时,完全摆脱了那种机器特有的无限气息平铺直叙,展现出如同活生生的人类在呼吸换气时的生理律动美感。
伴随式记忆流与跨轮次情感因果守恒控制
在长期陪伴交互体系中,另一大技术挑战是情感因果的跨轮次一致性与记忆沉淀。很多对话系统在单句回复中表现惊艳,但在经历数十轮沟通后,往往暴露出严重的‘情感失忆’:刚刚还沉浸在对严肃话题的深刻共鸣中,下一句却突然因为触发了通用回复模板而展现出亢奋欢快的播音声腔,这种割裂感会瞬间击碎用户的信任建立过程。
前沿工程团队引入了情感状态注意力衰减与因果守恒网络。该机制将整个对话生命周期的情绪能量波动记录在专用的伴随式记忆流中。每次生成新的语音反馈时,系统不仅参考当下的文本语义,更将历史轮次的情绪动能作为边界约束条件进行衰减卷积。即使话题发生转移,AI的音色声调也会保持符合心理过渡周期的渐进式调整,确保陪伴人格在长周期互动中始终维持鲜明、沉稳且具有个性一致性的内在灵魂。
极端情绪波动下的声学生物特征保真与抗畸变调试
当对话涉及剧烈的情感起伏或特殊表达形态(如急促打断、激动的哭腔或轻声抽泣)时,声学特征往往会偏离神经网络训练集中分布最密集的常规发音常模。在传统的端到端声音克隆体系中,一旦情感参数拉满,模型极易突破流形流动的安全边界,导致输出波形发生相位撕裂、啸叫或音色变成陌生人的灾难性畸变。
为了在极端情绪张力下依然守护说话人声纹特征的绝对保真度,架构师在潜空间内部设计了正交投影视角。该模块将说话人声带固有几何结构的生理声纹特征,与受情绪驱使的动态形变特征进行数学上的严格正交解耦。情绪网络无论如何大幅度拉伸音调高低、气流速度与能量包络,正交投影都会如同安全绳一般牢牢锚定核心发音人的生物指纹。这项工程实证的落地,让高情感伴随式数字人在医疗心理疏导、特种陪伴机器人以及沉浸式交互娱乐中真正具备了走向工业级稳定服役的基石。
在深层防御调试中,系统还内嵌了动态李雅普诺夫稳定性判据。每当情感扰动因子趋近于流形边界的奇异点时,阻尼抑制矩阵会自动在反向微分流中引入平滑张量,防止声码器在极限工况下发生高频自激振荡。正是这套严密的数学边界约束与生理动力学仿真的相互融合,使得人机交互不再是一串冷硬数据的吞吐,而是一场充满细腻知觉、深层共情与人文艺术美感的无声滋润。
推理延迟
12ms
识别精度
98.4%